КОНЦЕПЦИЯ
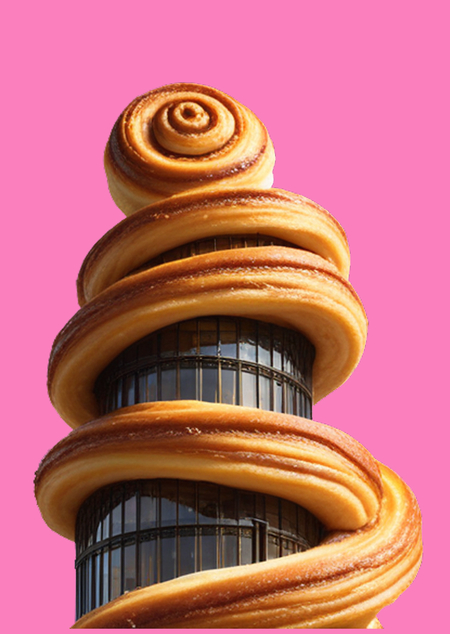
Съедобный город SWEETOPIA — серия архитектурных визуализаций, в которых формы реальных десертов становятся основой зданий.
Цель обучения — адаптировать Stable Diffusion XL к сочетанию узнаваемой формы выпечки и архитектурных деталей: входов, окон, фасадов и остекления.
ВДОХНОВЕНИЕ И РЕФЕРЕНСЫ
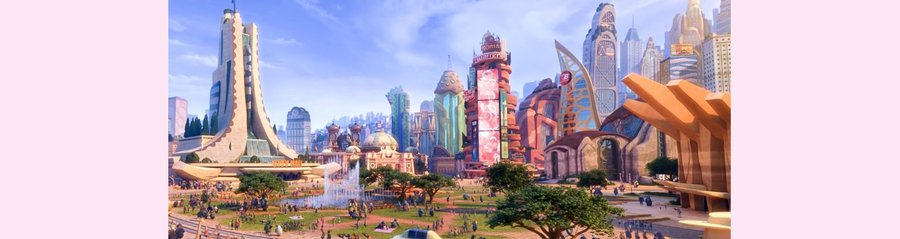
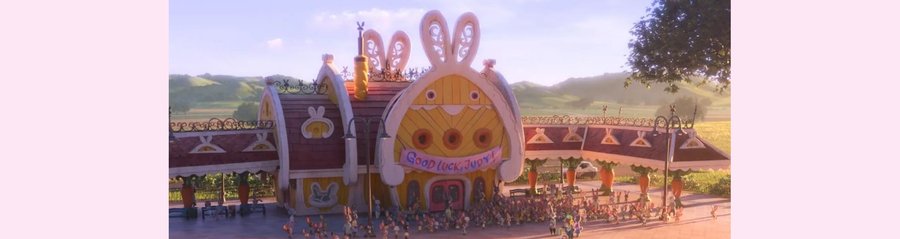
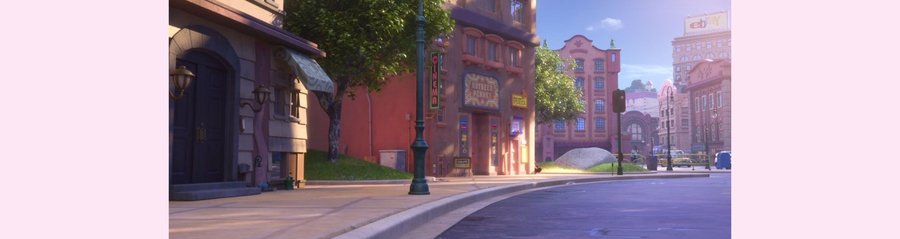
Кадры из мультфильма «Зверополис», 2016 года
Я очень люблю мультик «Зверополис/Zootopia» и довольно часто пересматриваю все части с младшей сестрой. Графика, цвета, необычные формы, креатив и много другое — очень вдохновляет меня, как графического дизайнера. Я каждый раз с восторженными глазами всматриваюсь в детали и восхищаюсь работой создателей этой графики.
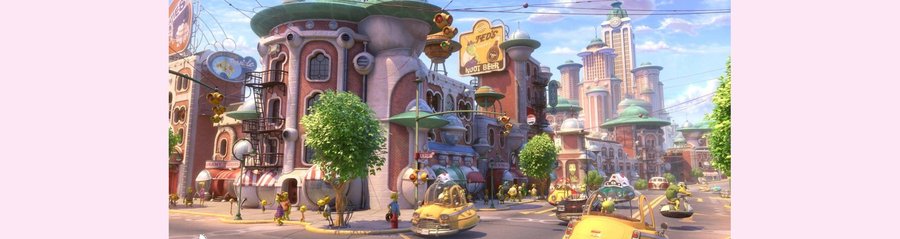
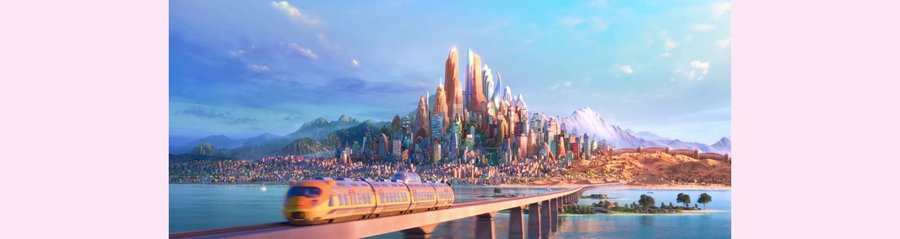
Кадры из мультфильма «Зверополис», 2016 года
Также я недавно была в настоящем Зверополисе в Шанхае и это и послужило еще большим вдохновением.
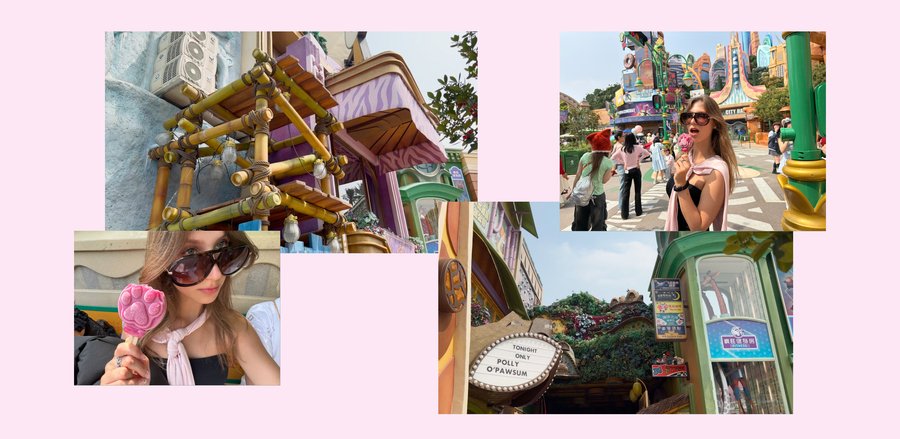
Диснейленд в Шанхае, Зверополис, 2026 год
Поэтому посмотрев требования к этому проекту, я поняла, что точно хочу сделать архитектуру/здания в похожем стиле и пофантазировать — как бы выглядела моя версия мультика «Зверополис».
Ну и напоследок: я люблю сладости и всё, что связано с эстетикой десертов, это также повлияло на тему!
Кадры кафе с пончиком из мультфильма «Зверополис», 2016 года (для самих генераций я брала обычные фотографии десертов из интернета, или описывала их; мультик служит только как вдохновение)
ОБУЧАЮЩИЕ МАТЕРИАЛЫ
Основной датасет состоит из 18 квадратных изображений размером 512 × 512 пикселей. Это синтетические архитектурные изображения, созданные с помощью генерации изображений в ChatGPT и отобранные для проекта. В набор входят круассан, эклер, канеле, мильфей, синнабон, дораяки, паштел-де-ната и другие десерты.
Каждому изображению соответствует индивидуальная англоязычная подпись с описанием формы десерта, материалов и архитектурных элементов.
ПАРАМЕТРЫ
Базовая модель — stabilityai/stable-diffusion-xl-base-1.0. Для адаптации применялся DreamBooth LoRA на основе обучающего скрипта Hugging Face Diffusers 0.35.1. В Google Colab использовался GPU и отдельное Python-окружение. Обучался LoRA-адаптер для UNet.
• Датасет: 18 изображений; разрешение: 512 × 512.
• Число шагов: 180; LoRA rank: 16; learning rate: 0,00005.
• Batch size: 1; накопление градиентов: 4 шага; точность: fp16.
• Оптимизатор: 8-bit Adam; gradient checkpointing: включён.
• Seed обучения: 2147; промежуточная контрольная точка: 90 шагов.
• VAE: madebyollin/sdxl-vae-fp16-fix.
ХОД ОБУЧЕНИЯ
Первый пробный эксперимент проводился на 30 изображениях с общей подписью: 100 шагов, LoRA rank 8. Полученные результаты недостаточно последовательно воспроизводили форму конкретных десертов. После анализа был сформирован набор из 18 более целевых изображений с индивидуальными подписями.
В основном эксперименте обучение завершилось на 180-м шаге. Это подтверждается training.log. В результате сохранён файл pytorch_lora_weights.safetensors размером около 93 МБ. Он содержит веса адаптера, подключаемого к базовой SDXL для генерации.
ПРОВЕРКА РЕЗУЛЬТАТА
Для шести тематических запросов получено по три изображения при силе LoRA 0.0, 0.5 и 0.8 (18 контрольных генераций). Внутри каждой тройки использовались одинаковые промпт и seed. Это позволяет сопоставить результат базовой SDXL с изображениями, созданными при подключении адаптера. Для контрольной генерации применялись 512 × 512 пикселей, 30 шагов и guidance scale 7.0.
После контрольного этапа проводились дополнительные целевые генерации с более подробными запросами. В промптах уточнялись тип десерта, общий силуэт, материал поверхности, расположение входа и окон; отрицательные запросы ограничивали появление коллажей и посторонних объектов. Отобранные изображения сохранены в исходном виде, без дорисовки или замены деталей.
ФИНАЛ
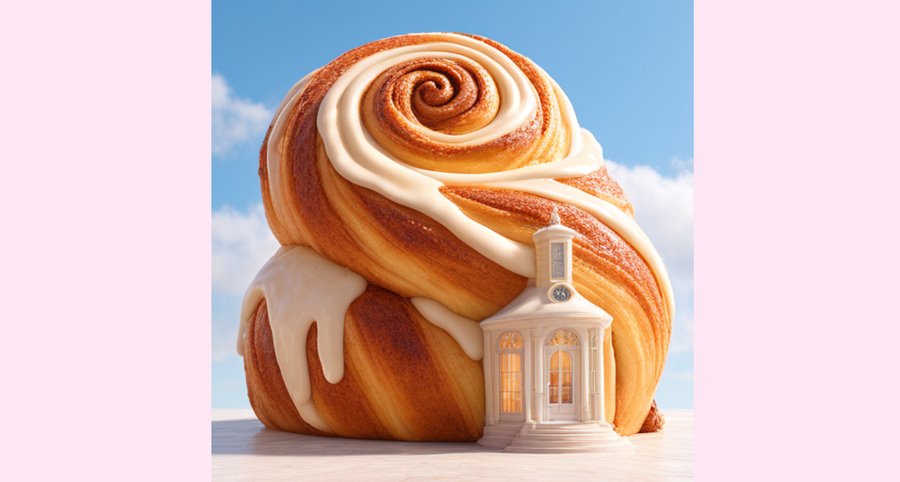
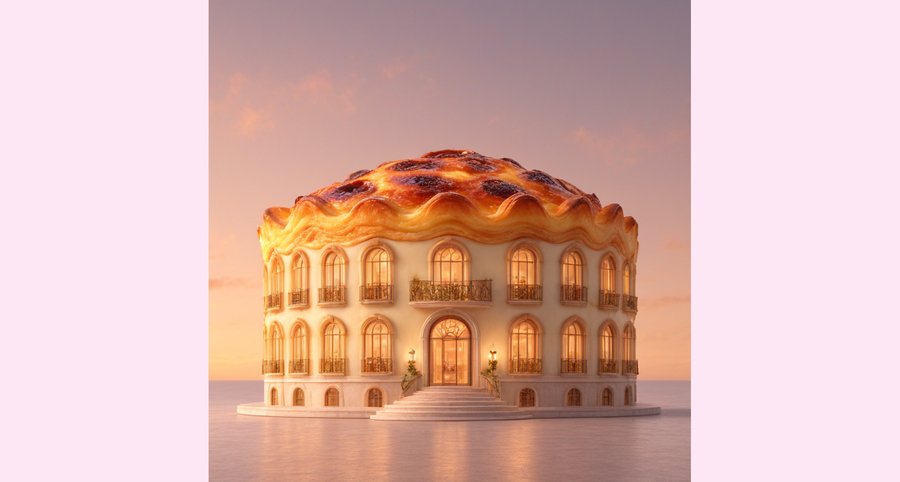
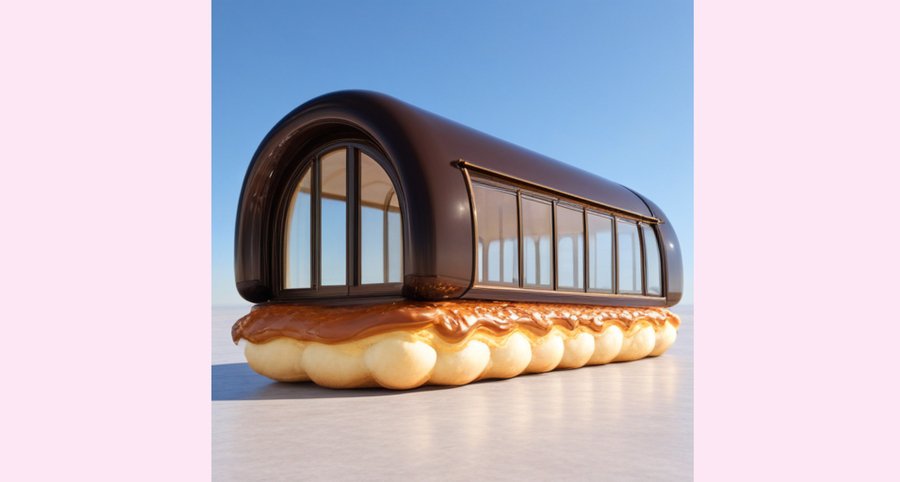
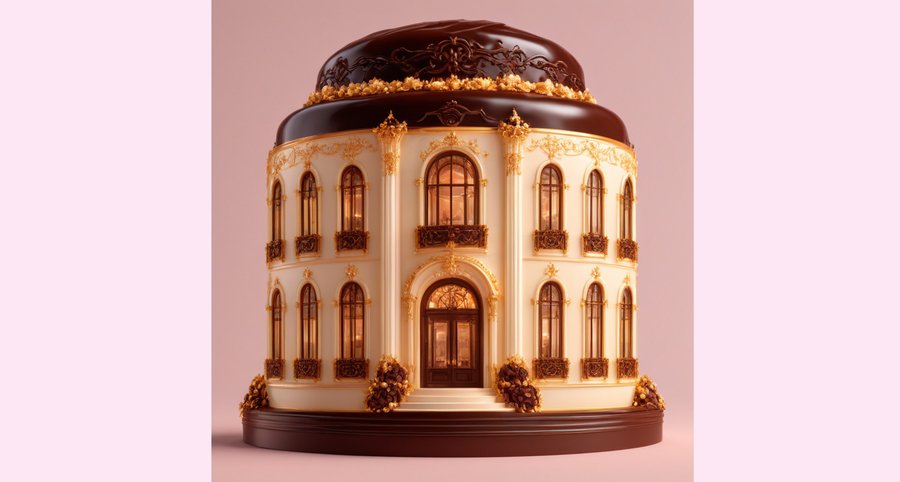
Для финала было отобрано девять изображений: музей-круассан, центр-синнабон, галерея-эклер, галерея-канеле, центр-дораяки, библиотека-мильфей, музей-паштел-де-ната, музей «Захер» и дополнительный вариант «Синнабон — башня».
Таким образом, представлены восемь десертных мотивов и две разные архитектурные интерпретации синнабона.
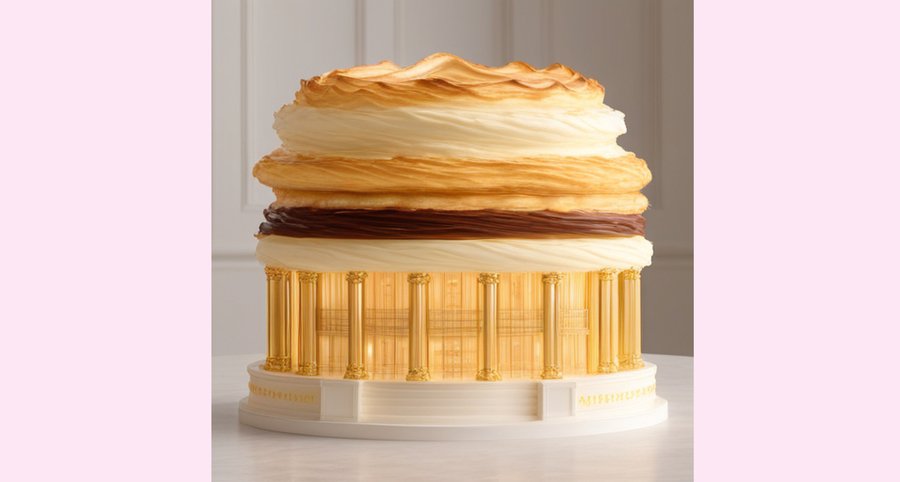
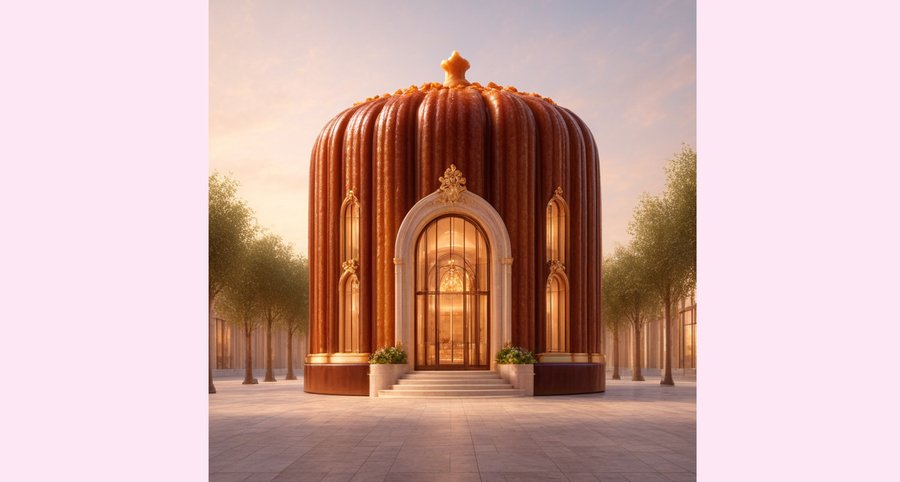
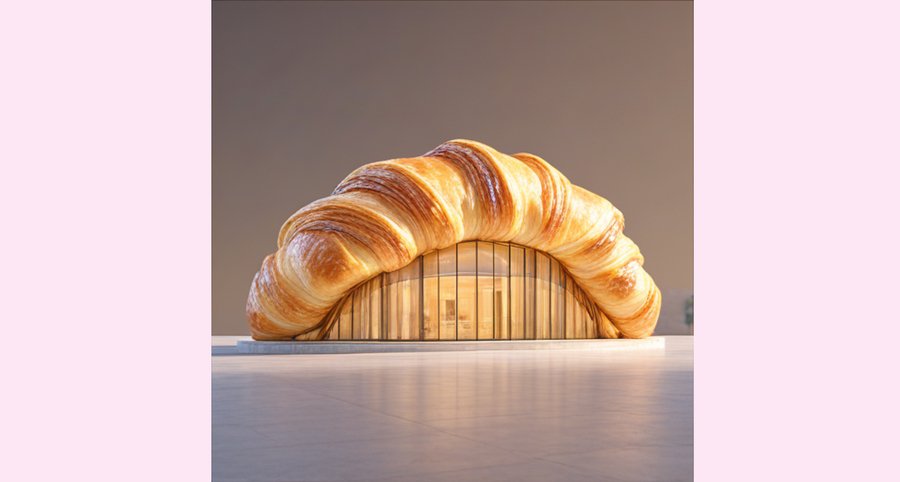
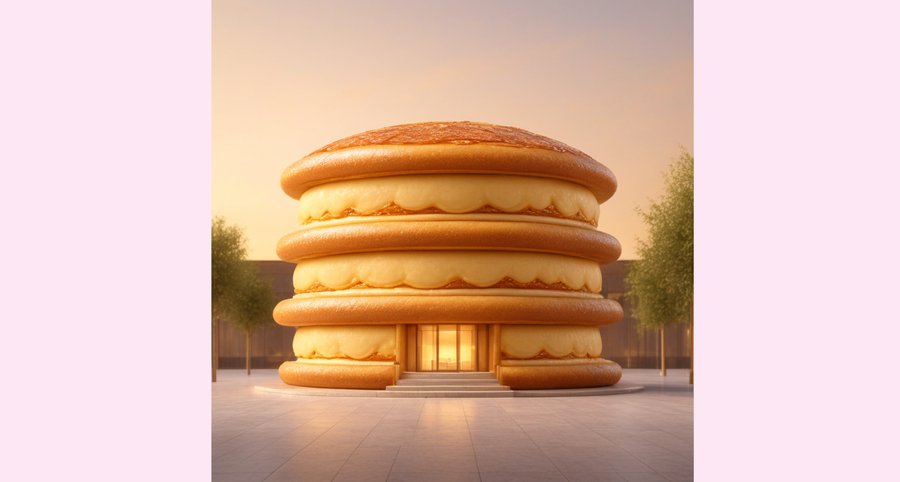
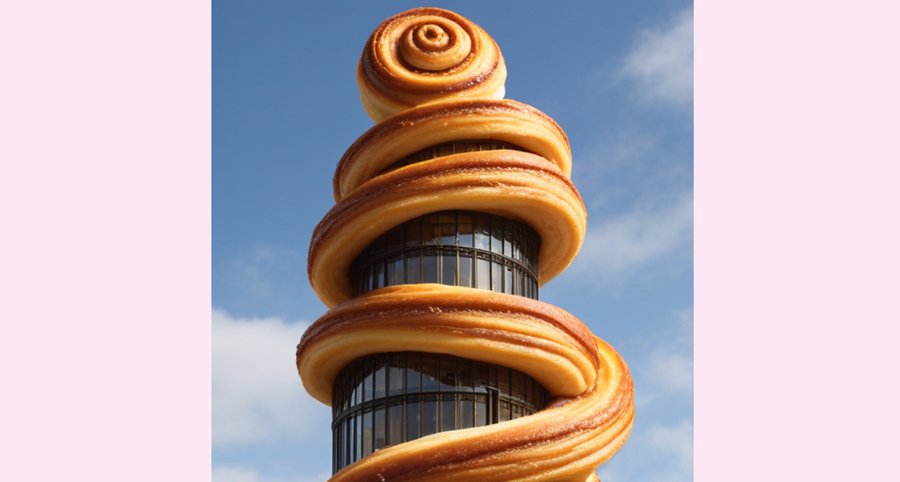
Галерея-канеле
АНАЛИЗ ФОРМ
Круассан и синнабон дают выразительный узнаваемый силуэт, эклер — вытянутый объём, канеле — характерный вертикальный рельеф. У мильфея и дораяки важнее чередование слоёв, у паштел-де-ната и «Захера» — фактура и оформление верхней части здания. Различия между результатами показывают несколько способов переноса признаков десерта в архитектуру.
ОПИСАНИЕ
ChatGPT применялся для разработки и уточнения идеи, создания синтетических обучающих изображений, помощи в подготовке кода, промптов и текстового описания. Итоговые изображения получены с помощью Stable Diffusion XL с обученным LoRA-адаптером.
ИСТОЧНИКИ
Stable Diffusion XL: https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0
DreamBooth LoRA SDXL: https://github.com/huggingface/diffusers/blob/v0.35.1/examples/dreambooth/train_dreambooth_lora_sdxl.py
ChatGPT: https://openai.com/chatgpt/
ВЫВОД