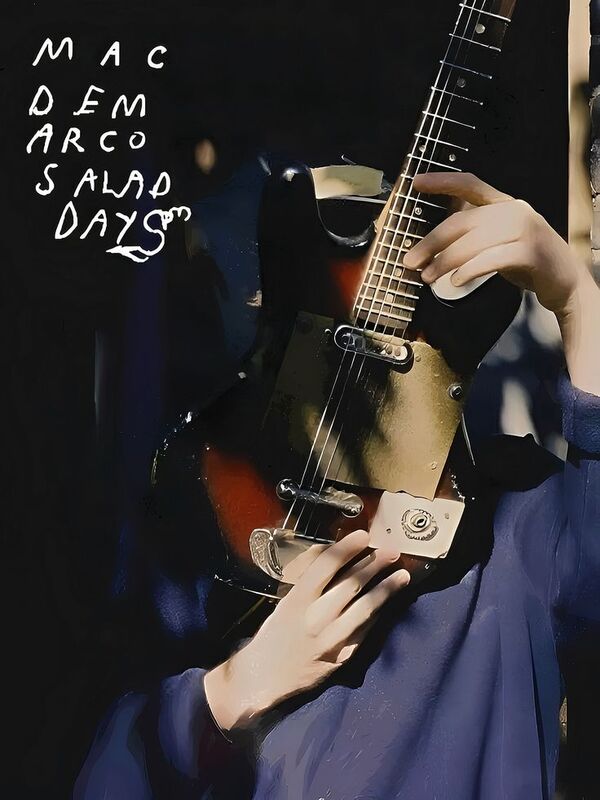
Missing Hippie Jon, salad days are gone,
Remembering things just to tell ‘em so long.
Salad Days by Mac DeMarco
Описание проекта
Mac DeMarco — заметная фигура современной инди-сцены, чьё творчество сочетает нарочито простую, расслабленную эстетику с чёткой авторской интонацией. Его музыка часто описывается как «slacker rock»: неторопливое звучание, ло-файная теплотa и лёгкая самоирония, за которыми скрывается внимательное отношение к личному опыту и эмоциональным состояниям.
Лирика Mac DeMarco носит дневниковый, интимный характер. В текстах регулярно появляются темы любви, одиночества, взросления и повседневных привычек, поданные через простые и повторяющиеся образы. За внешней непритязательностью таких текстов скрывается устойчивая эмоциональная структура, что делает их особенно интересными для лингвистического и статистического анализа.
Именно поэтому в фокус моего исследования попал Mac DeMarco. Помимо аналитического интереса, этот выбор во многом личный: его музыка для меня особенно ценна — песни Mac DeMarco всегда помогают успокоиться, замедлиться и расслабиться. Эта эмоциональная близость к материалу делает анализ не только исследовательским, но и осознанным, позволяя глубже вникнуть в лексические и эмоциональные особенности его текстов.

Обложки популярных альбомов Mac DeMarco
В качестве визуального решения я использовала обложку альбома Salad Days как колористический ориентир. Из обложки был извлечён основной набор цветов с помощью Adobe Color.
В цветовую палитру вошли основные оттенки: 323F59, 5A758C, D7D9D7, 8C6C5A, которые применялись для оформления графиков, фона и ключевых визуальных элементов. Второстепенные нейтральные цвета использовались для текста и подписей, чтобы обеспечить контраст и читаемость.


Цветовая палитра.
Сбор данных Подготовка датасета
Первым шагом в проекте стало формирование корпуса текстов песен Mac DeMarco, с которым дальше можно было работать: анализировать лексику, структуру и эмоциональную окраску композиций. Для этого было важно получить достаточно большой и одновременно осмысленный набор данных, а не случайную выборку.
С помощью Genius API я загрузила тексты 120 самых популярных песен Mac DeMarco, отсортированных по популярности на платформе. Для автоматизации процесса был написан скрипт genius_script.py, который позволил получить данные напрямую из базы Genius без ручного вмешательства. Для каждой композиции сохранялись название песни и полный текст.
Инициализация и настройка Genius API


Ключевой этап предварительной обработки текста Расчет трех ключевых метрик для анализа Обработка пропусков в метаданных
Полученные тексты требовали предварительной обработки. На этом этапе я привела их к читаемому и унифицированному виду: удалила переносы строк, лишние пробелы и другие элементы, которые могли помешать дальнейшему анализу. Такая базовая очистка была необходима для корректного подсчёта текстовых метрик и последующей работы с данными.
Уже на этапе сбора данных я рассчитала несколько первичных количественных показателей, которые помогают описать структуру текстов песен. Для каждой композиции были посчитаны количество слов, количество символов, число уникальных слов, а также коэффициент лексического разнообразия — отношение количества уникальных слов к общему числу слов в тексте. Эти параметры дают первое представление о насыщенности и вариативности языка, используемого Mac DeMarco.


Первый вариант датасета после скрипта genius_script.py
После этого я занялась уточнением метаданных. Часть песен имела неполную информацию об альбомах и годах выпуска, что мешало анализировать дискографию и сравнивать композиции между собой. Но я столкнулась с проблемой неполных данных: некоторые альбомы отсутствовали в Genius API. Решением стало использование двух источников — Genius и Spotify — чтобы максимально покрыть все альбомы. С помощью Spotify API и скрипта spotify_script.py для песен с неизвестными альбомами был выполнен поиск по названию трека и имени артиста. В результате для большинства композиций удалось определить корректный альбом и год релиза.
Некоторые песни, которые не удалось сопоставить со Spotify, оказались каверами или композициями без текста, поэтому они были исключены из выборки. В итоге был сформирован очищенный и обогащённый датасет mac_demarco_lyrics.csv, содержащий тексты 103 песен, в котором для большинства треков указаны корректные альбомы и годы выпуска.


Инициализация Spotify API и обогащение данных через API


Обновленный вариант датасета после скрипта spotify_script.py
Для автоматической проверки итогового датасета я написала скрипт data_checking.py. Он проверял все элементы датасета на наличие всех данных. В консоль выводились итоги проверки, а также минимальный анализ датасета.


1. Загрузка данных и вывод общей информации 2. Валидация данных (поиск дубликатов и пустых значений)


Выведенная в консоль информация
Таким образом, на этапе подготовки был получен репрезентативный и качественный корпус данных, готовый для дальнейшего анализа лексики, структуры и эмоциональной окраски песен Mac DeMarco.
Для этого я использовала следующие библиотеки: lyricsgenius и spotipy для работы с API, pandas для обработки табличных данных, numpy для численных операций, textblob для анализа тональности текстов, а также collections.Counter для подсчёта частоты слов.
Анализ данных (analysis.py)
Для глубокого анализа текста я использовала различные библиотеки: библиотеку TextBlob для лингвистического анализа и Pandas для управления таблицами. Также я подключила Counter для подсчета слов и WordCloud для подготовки текстовых данных к визуализации.
Настройка импортов и загрузка данных
Главная цель анализа понять настроение песен. Я прошлась по каждой строчке датасета и вычислила два параметра: Polarity (настроение: от негативного к позитивному) и Subjectivity (степень субъективности текста).
Дальше я собрала все слова из всех песен в один список, очищаем их от базового шума и считаем количество упоминаний с помощью Counter. Как итог получен список лексического ядра артиста, который ляжет в основу визуализаций.
В этом же файле я подготавливаю специфические данные, которые потребуются в mac_visualisation.py, чтобы графики строились быстро и без ошибок. Группирую данные по альбомам и годам, вычисляя средние значения настроения для каждого периода творчества. В итоге я трансформировала сырой список песен в аналитическую таблицу, готовую к отрисовке.


Анализ тональности. Частотный анализ. Очистка от стоп-слов и подсчет оставшихся. Агрегация данных. Группировка датасета, вычисление ср. значений ключевых метрик. Временной анализ.
Все мои расчеты сохраняются в финальный файл, который объединяет в себе и исходную информацию, и результаты анализа.
Файл mac_demarco_lyrics_analyzed.csv готов. Теперь в нем есть не только тексты, но и колонки polarity, subjectivity и другие метрики.
Корреляционный анализ и сохранение данных для визуализации.
После завершения анализа текстов песен Mac DeMarco, выполненного с помощью скрипта analysis.py, мы получили расширенный датасет с количественными показателями: длина текста, число уникальных слов, лексическое разнообразие, тональность и категория тональности (Positive/Negative/Neutral). Дополнительно была сформирована статистика по альбомам, по годам выпуска и корреляционная матрица между метриками.


Проанализированный датасет
Итоговые графики