Идея
Проект исследует возможность передать нейросети не отдельный предмет или персонажа, а визуальную логику фотографической серии. В основе лежат чёрно-белые изображения музейных пространств, отражений в стекле, силуэтов посетителей, архитектурных фрагментов и городских улиц. Эти кадры объединяют приглушённая атмосфера, наложение текстур и дистанция между наблюдателем и изображением.
Задача эксперимента: проверить, сможет ли модель воспроизводить устойчивые признаки серии при изменении сюжета, пространства и композиции.
Исходные изображения
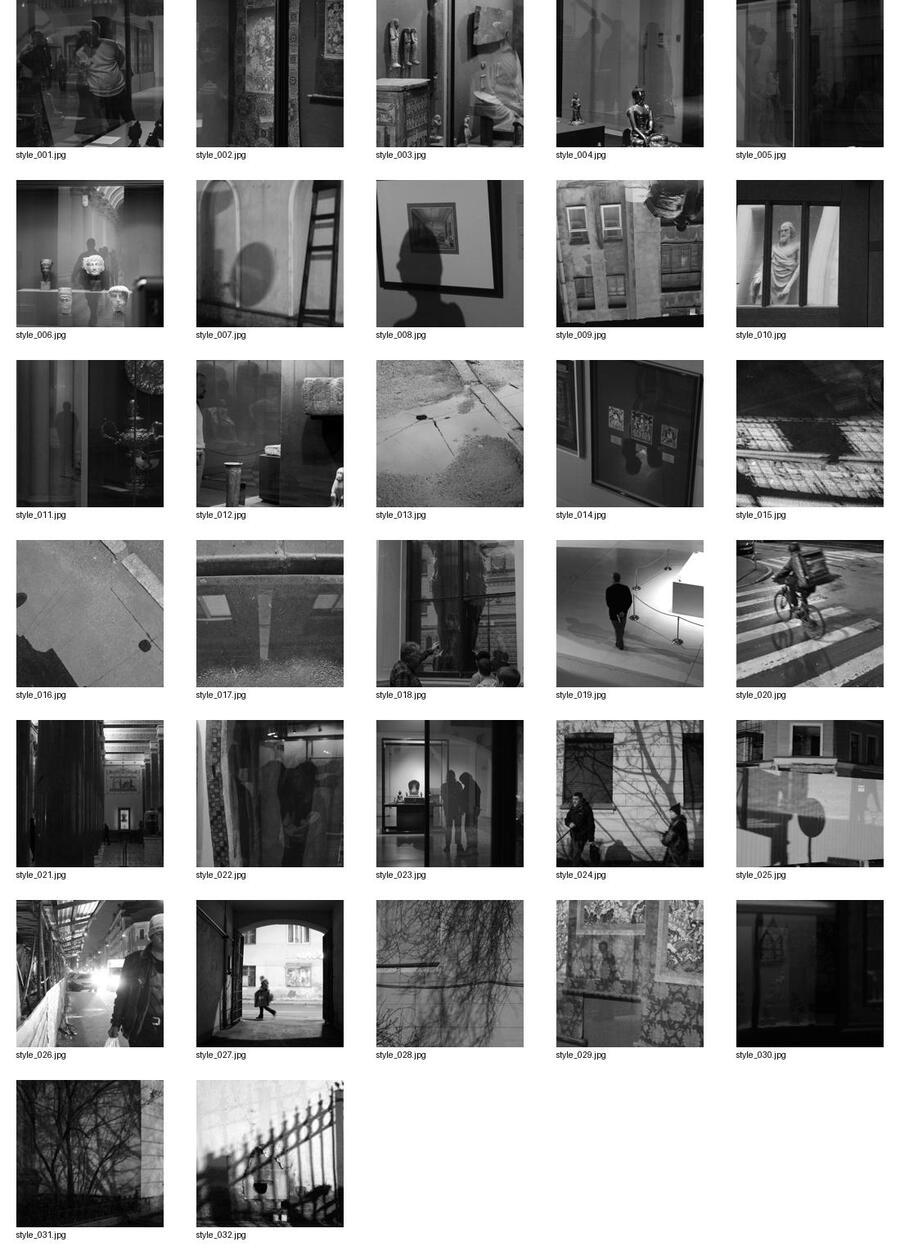
датасет из 32 квадратных фотографий размером 512 × 512 px
Метод
Базовая модель — Stable Diffusion XL 1.0. Для адаптации используется LoRA: обучается небольшой набор дополнительных параметров, который связывает специальный текстовый маркер obsrvstyle
с визуальными закономерностями датасета. Черновые подписи создаются с помощью BLIP, затем проверяются перед обучением. Генерация выполняется по серии текстовых запросов с разными мотивами и фиксированными параметрами.
В ноутбуке используются разрешение обучения 512 × 512, 500 шагов, learning rate 1e-4, gradient checkpointing и смешанная точность FP16.
Итоговая серия
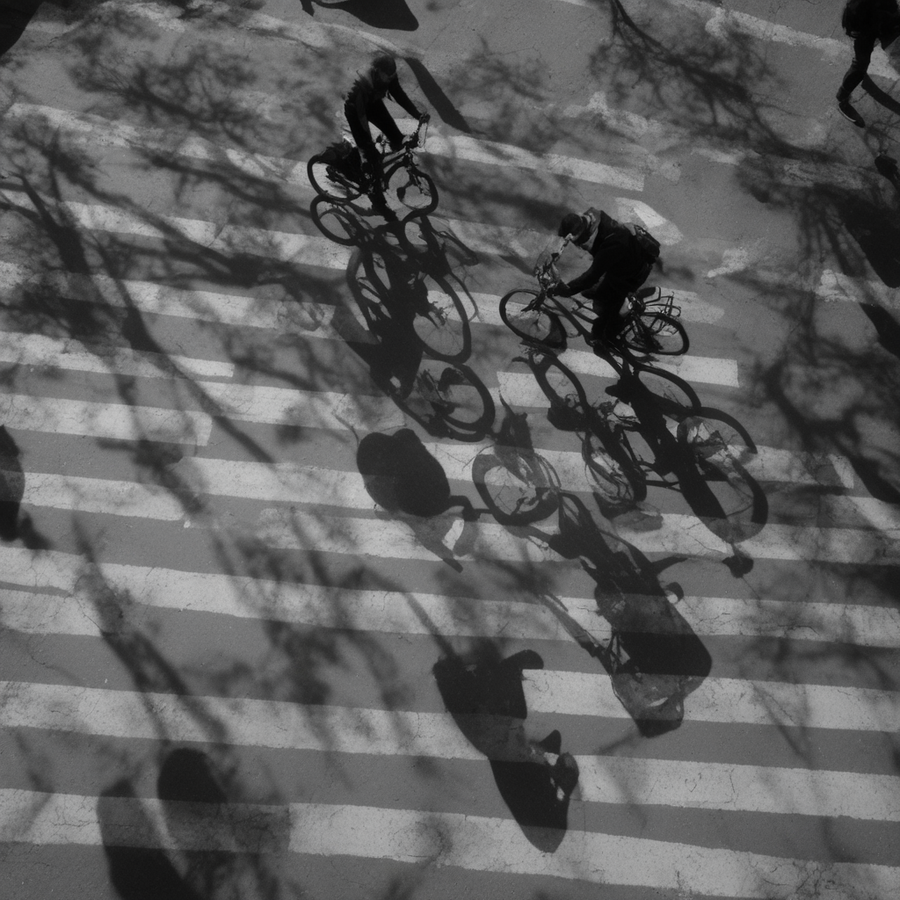
Серия построена как небольшое визуальное исследование четырёх мотивов: музей и стекло, силуэт и отражение, городская тень, архитектур. В итоге получилось 3 серии. Тени. Люди. Сюжеты.
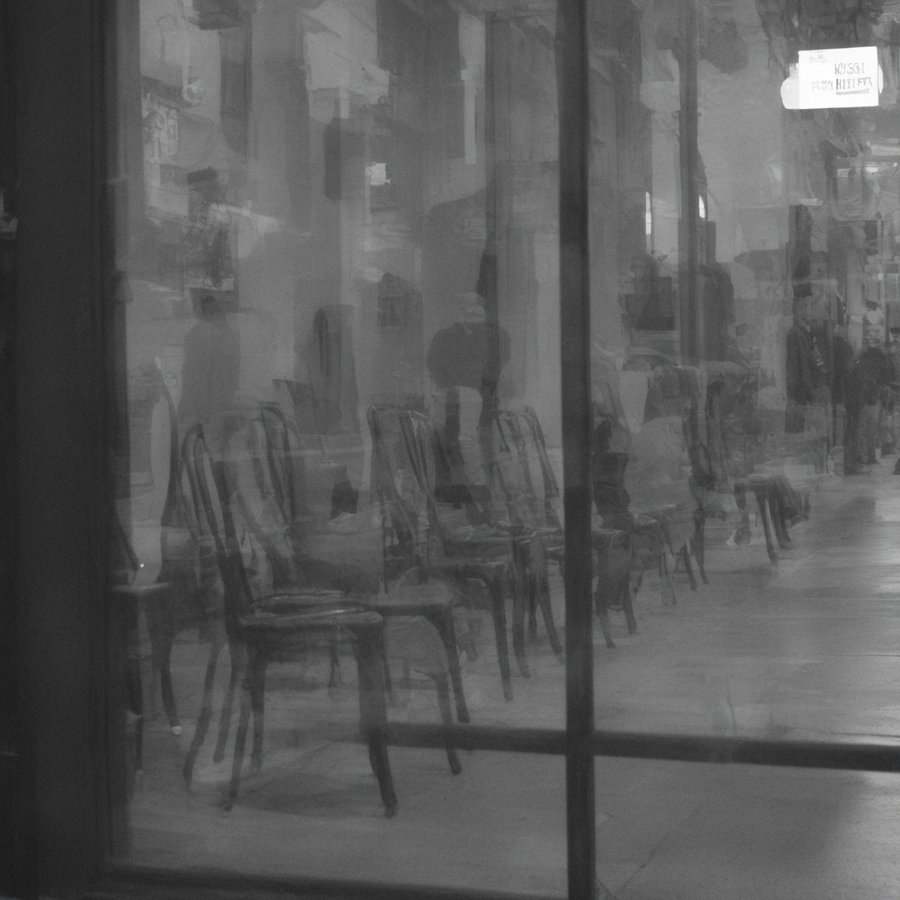
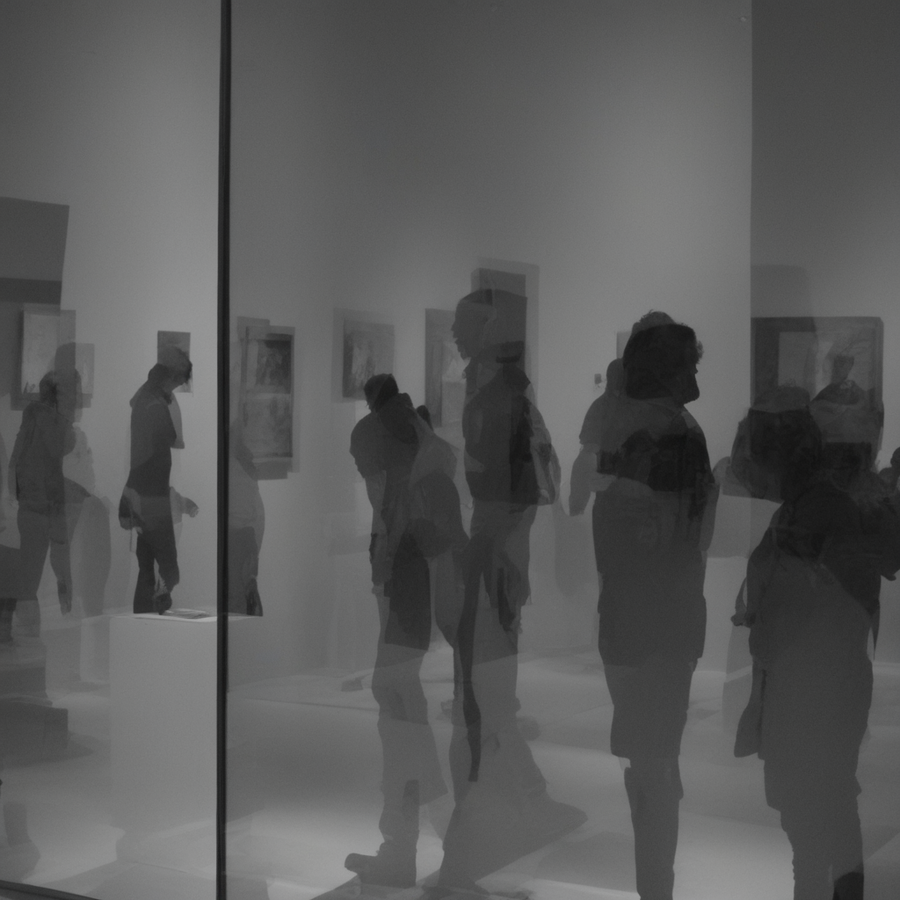
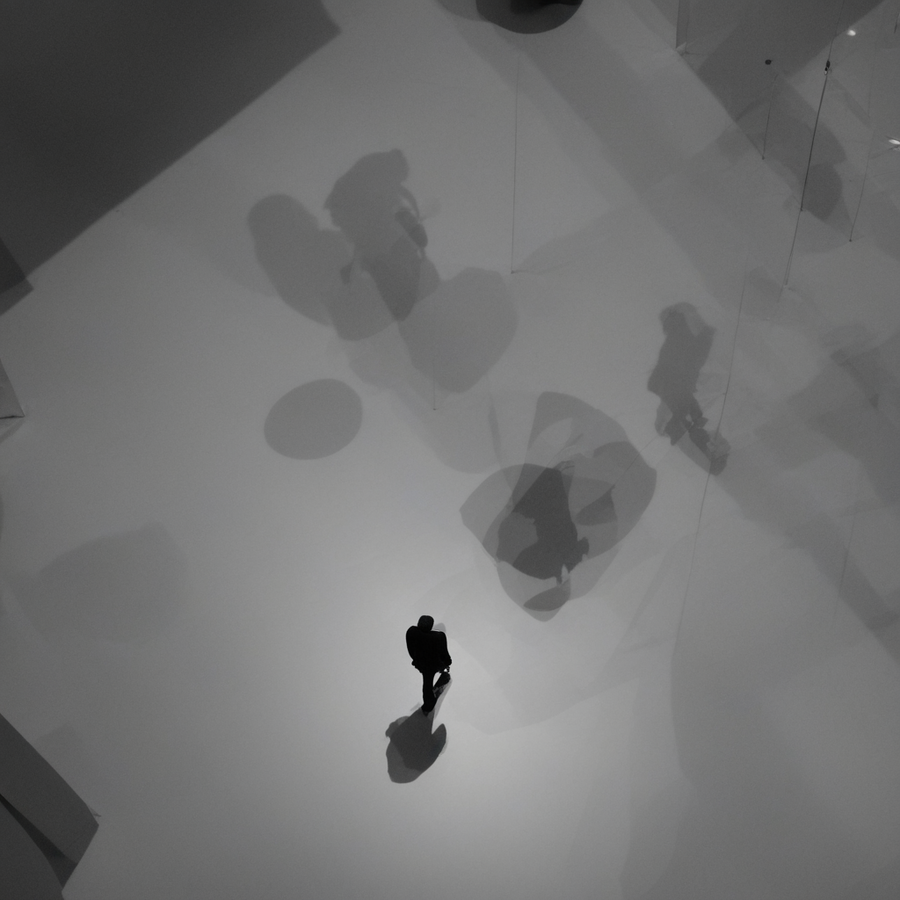
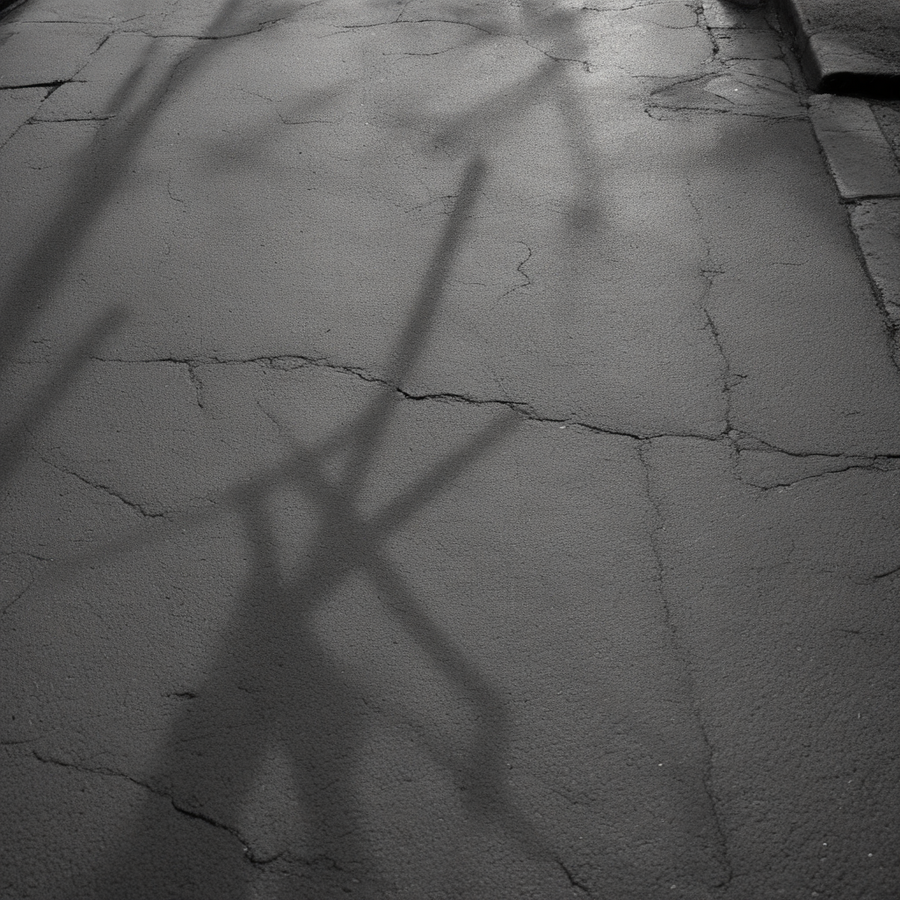
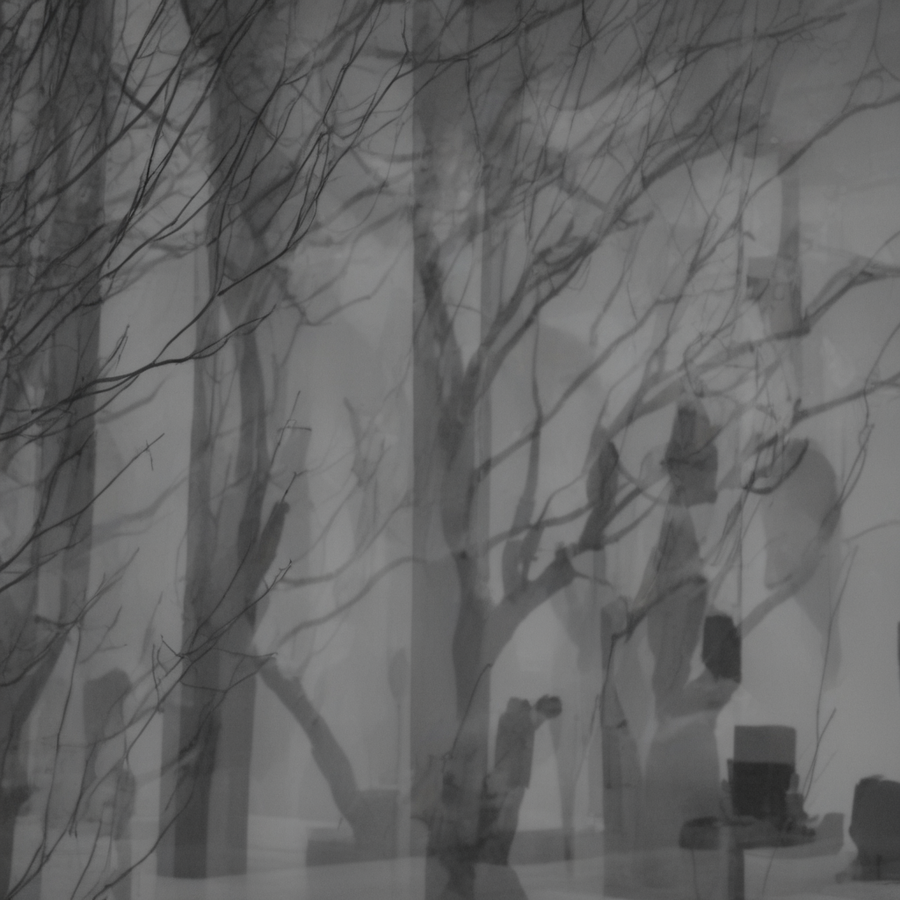
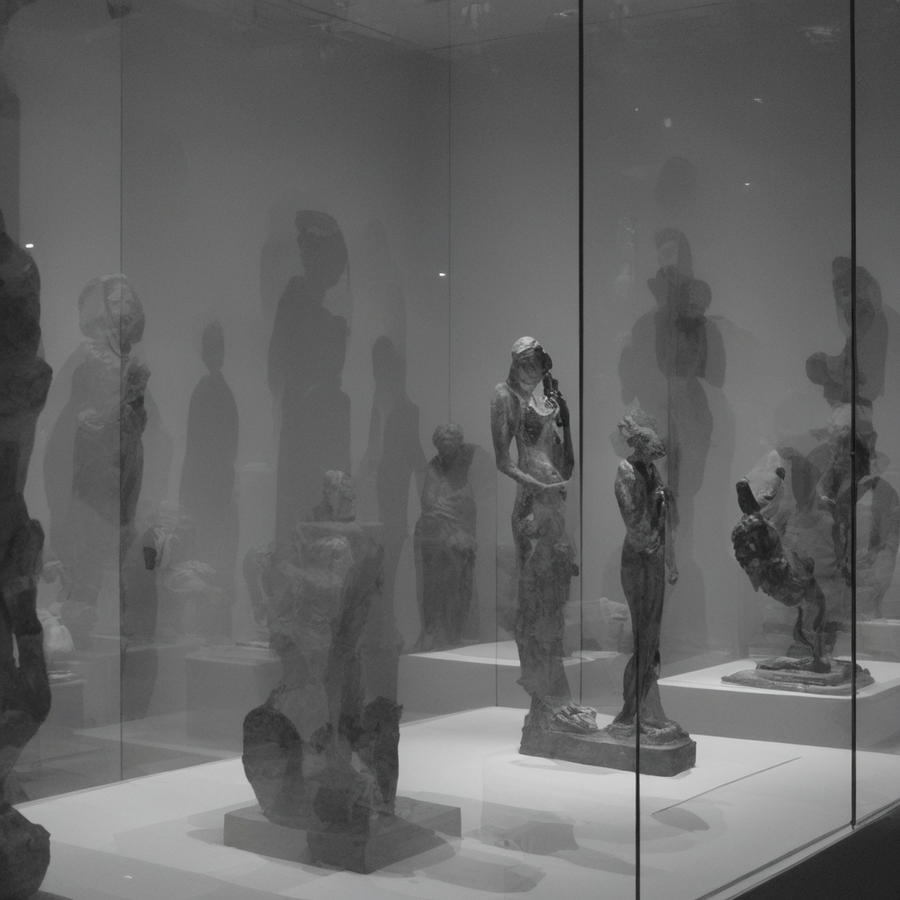
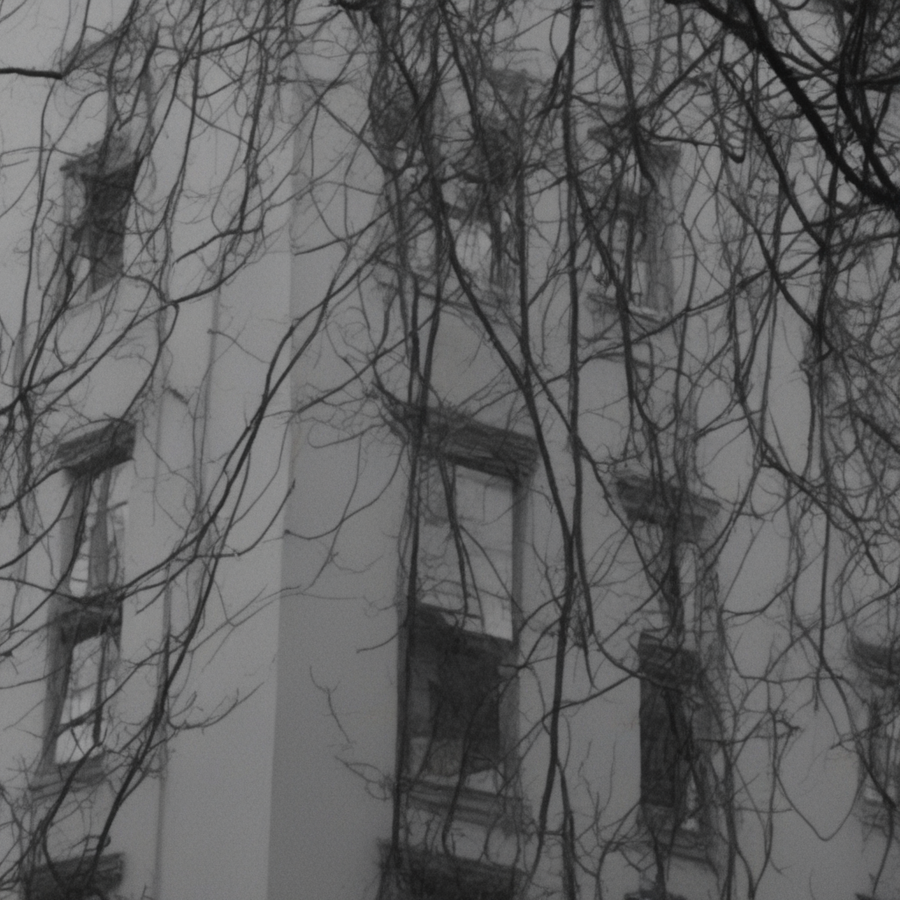
Сгенерировано с помощью Stable Diffusion XL + LoRA
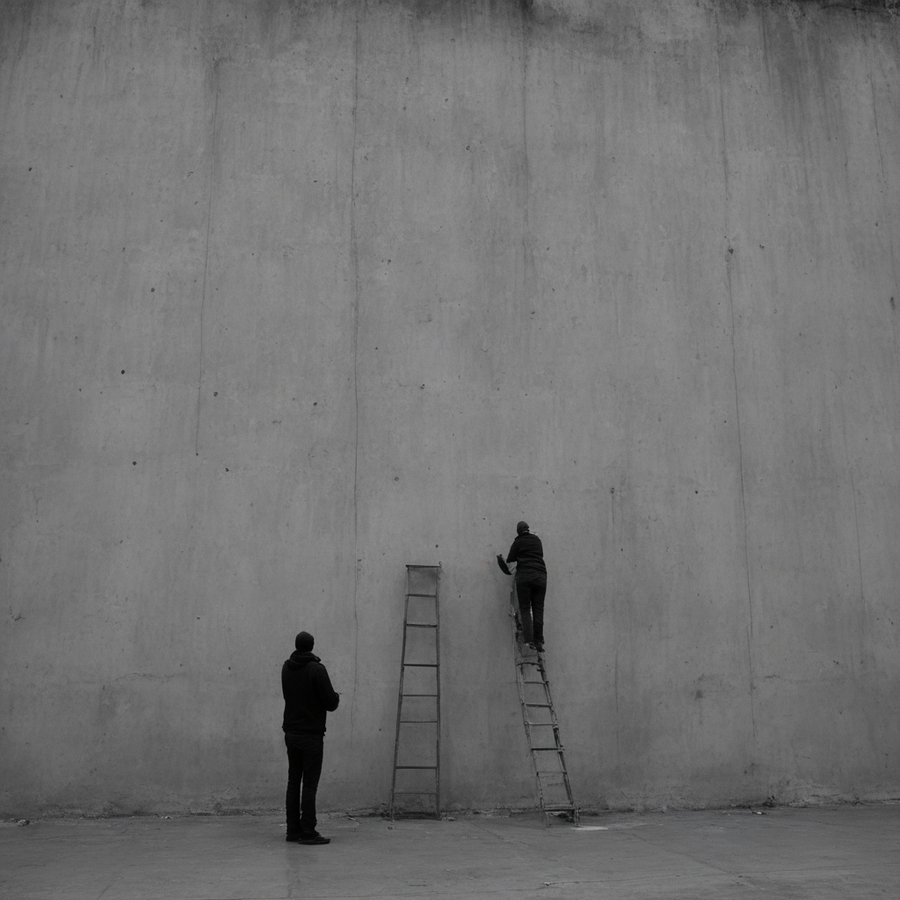
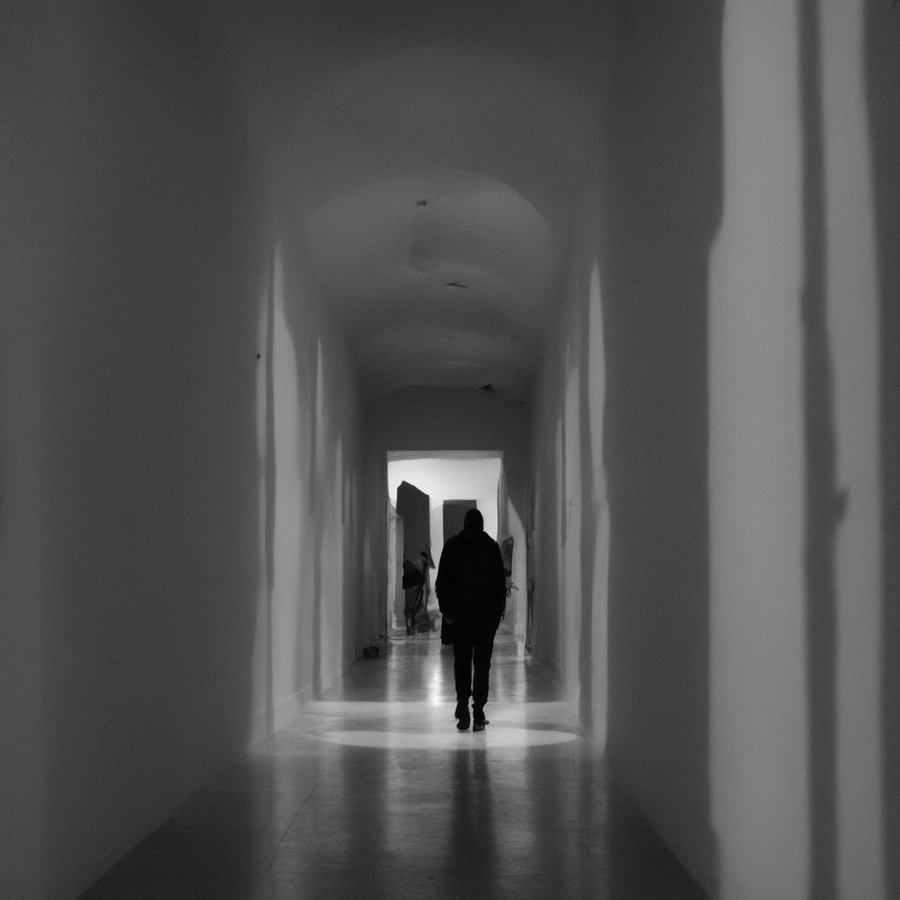
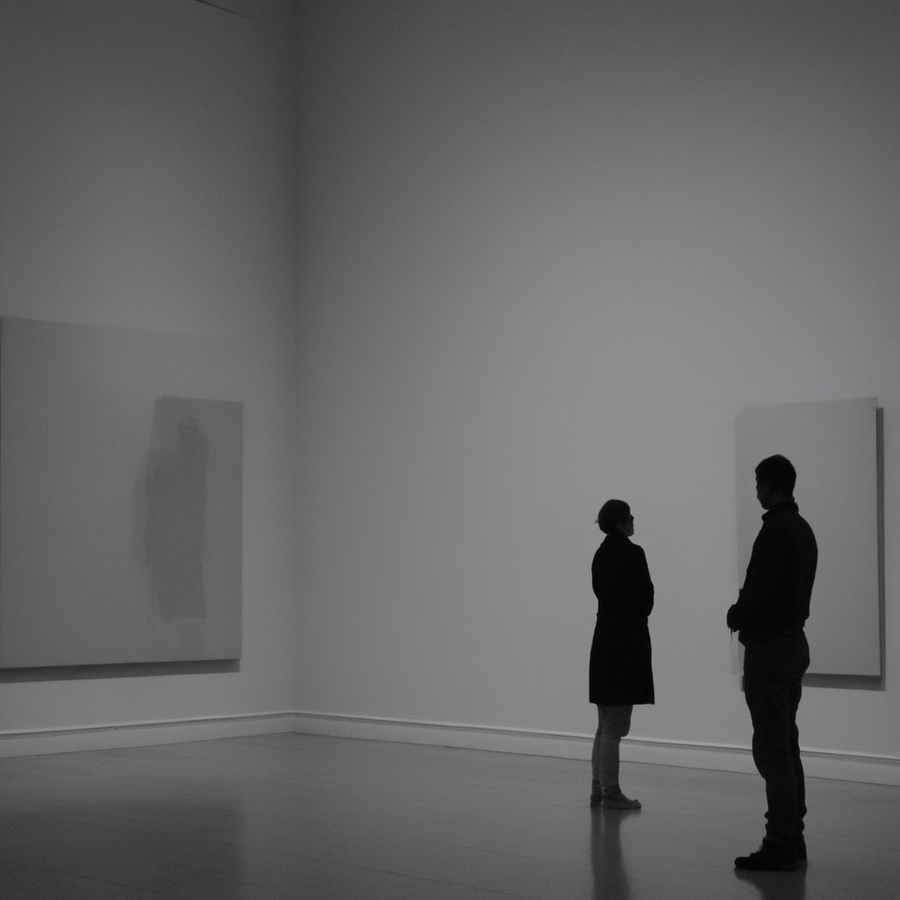
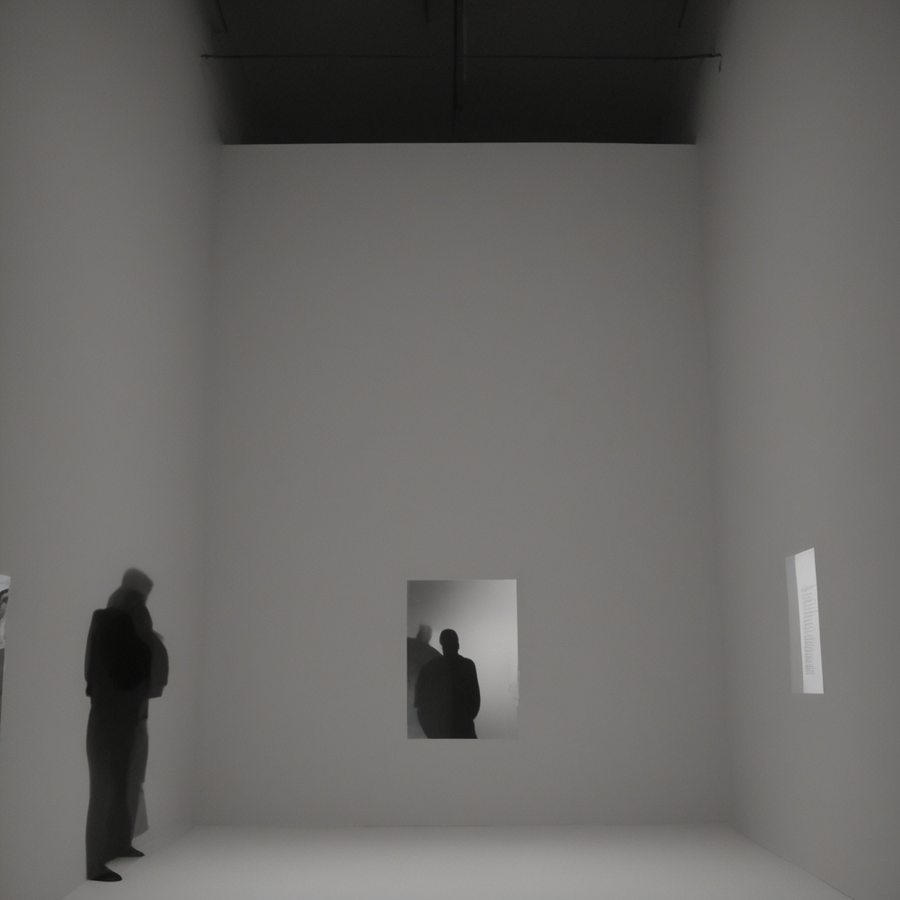
Сгенерировано с помощью Stable Diffusion XL + LoRA
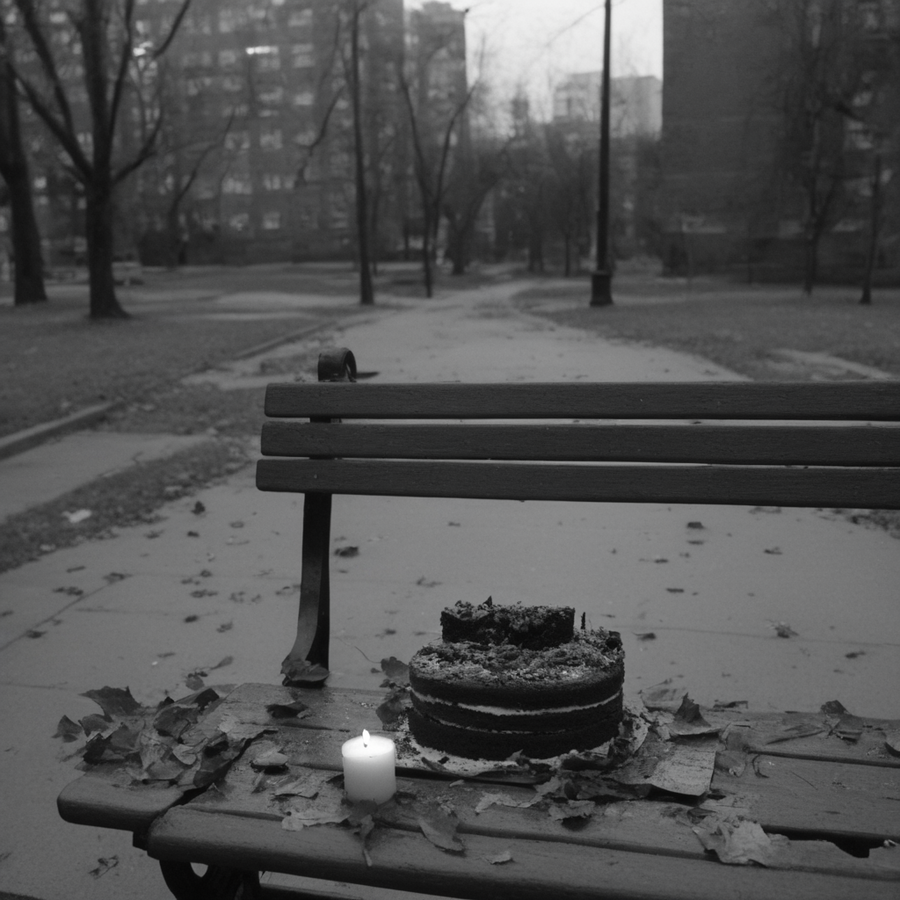
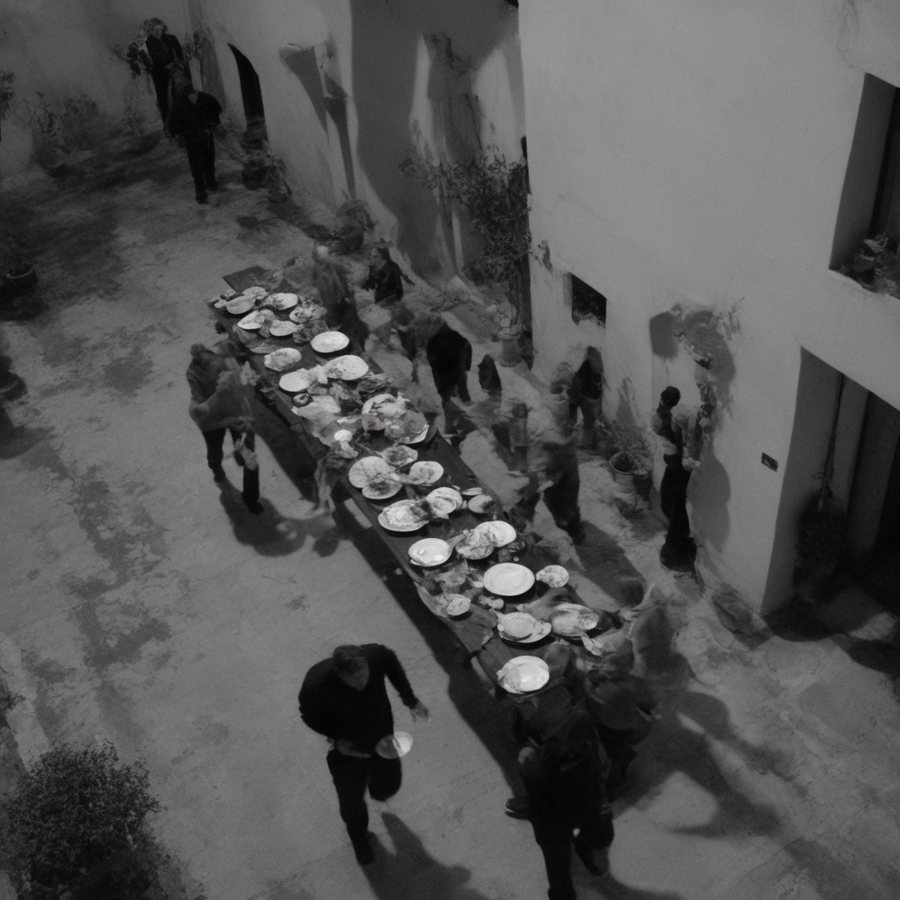
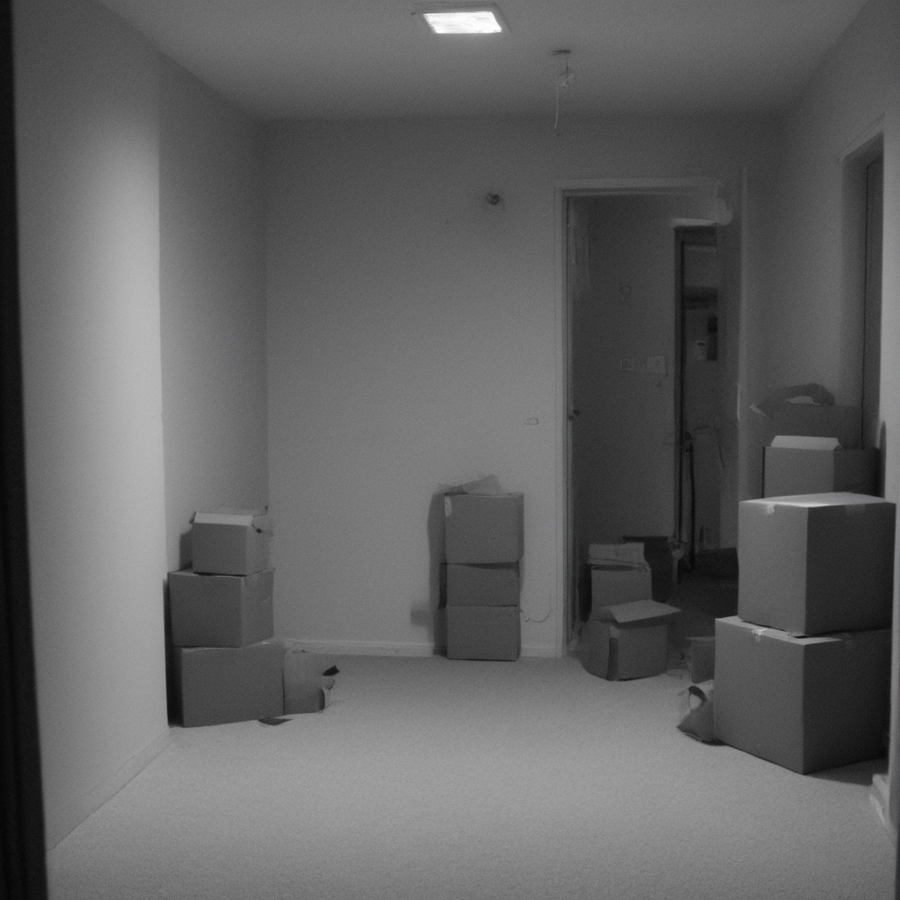
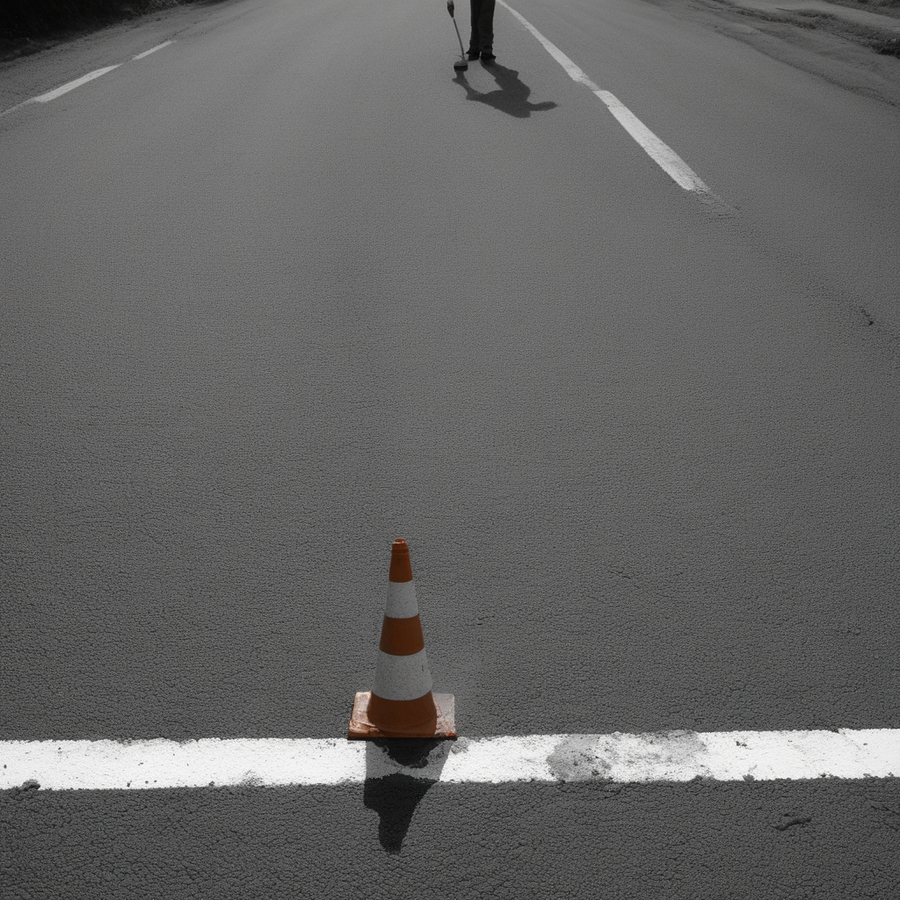
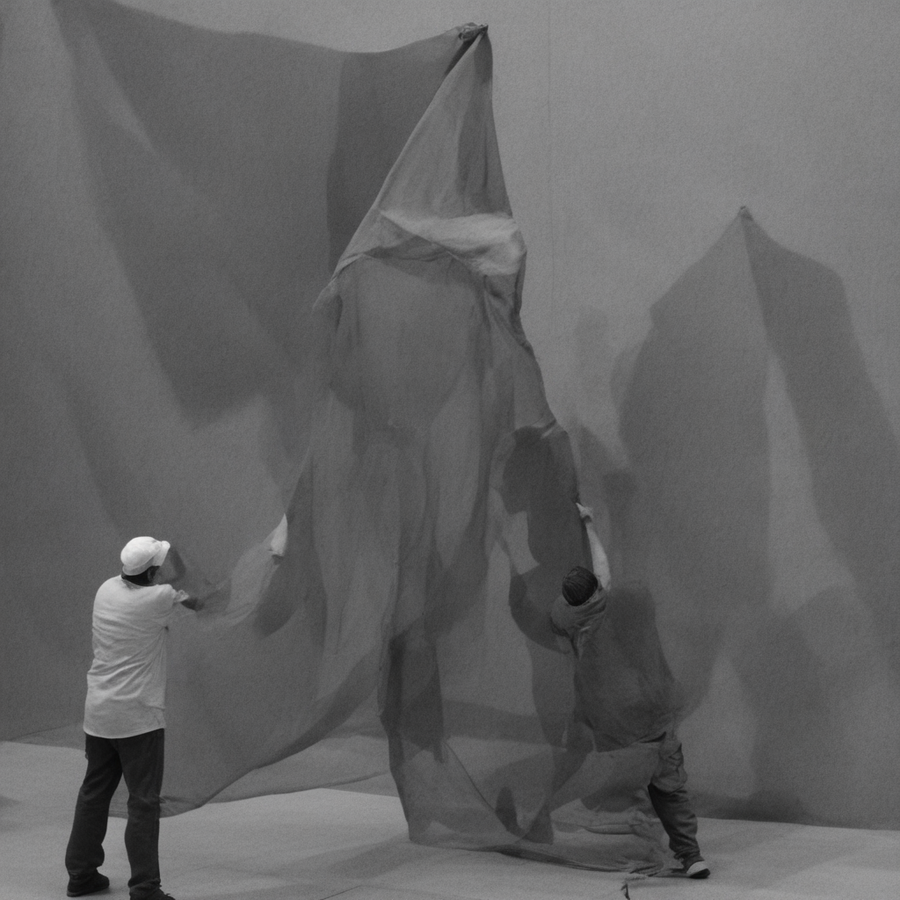
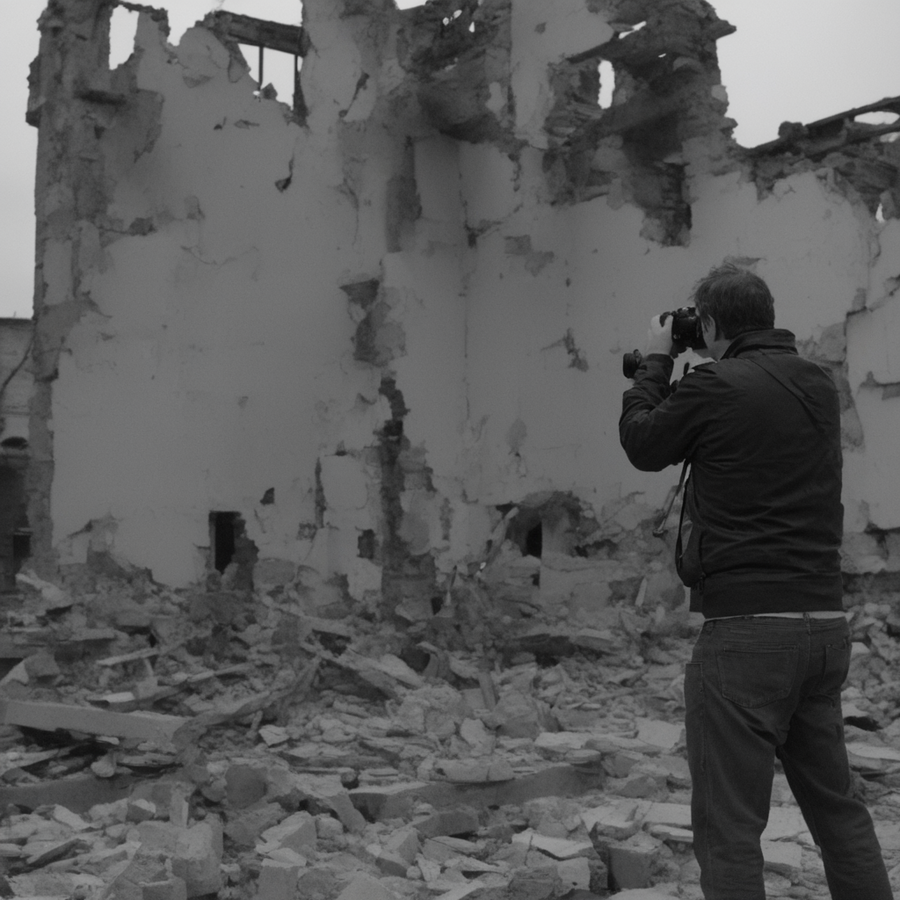
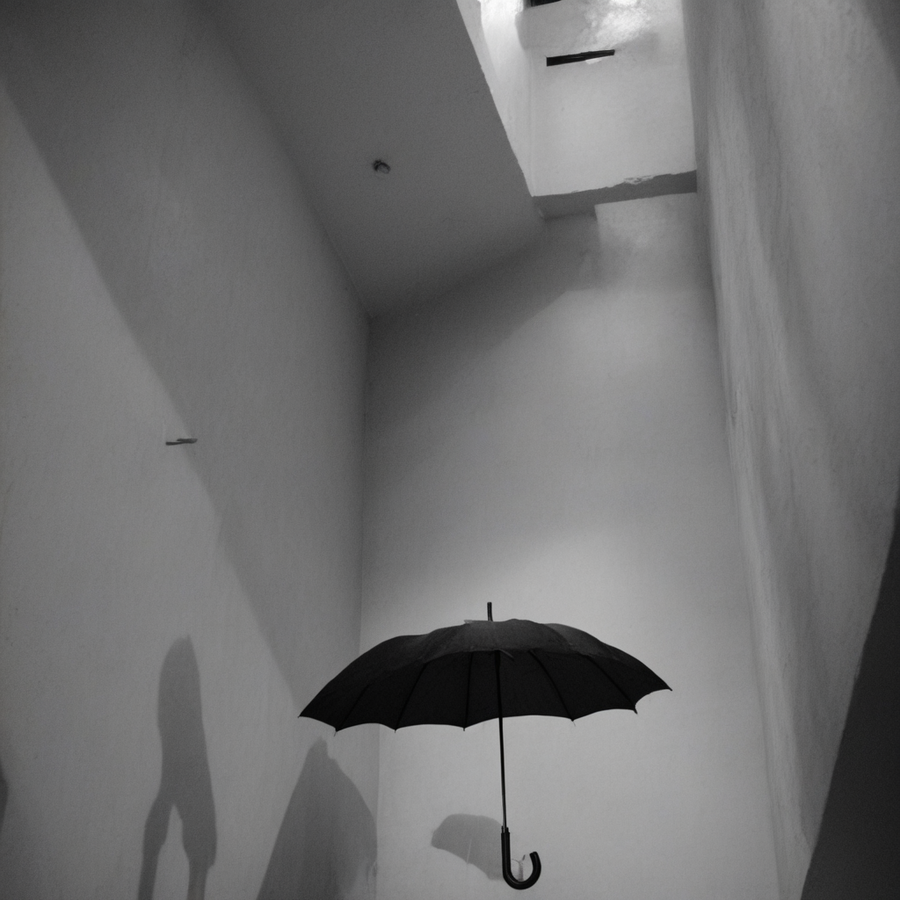
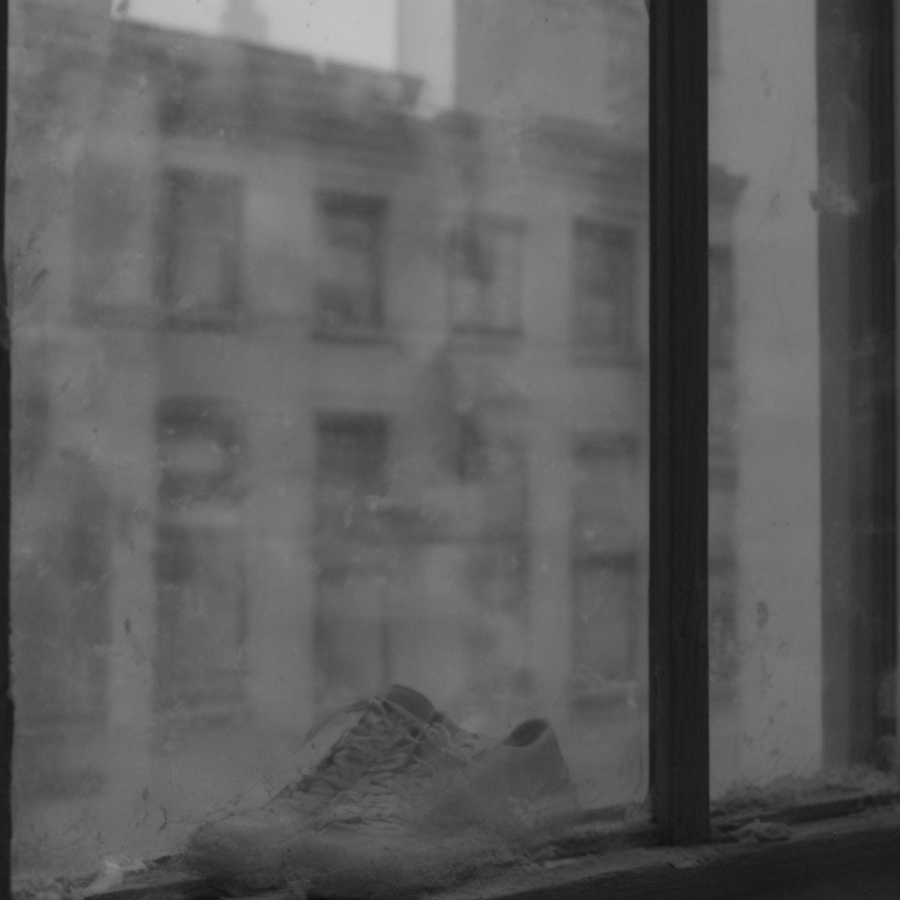
Сгенерировано с помощью Stable Diffusion XL + LoRA
Визуальный анализ
Итоговая серия изображений демонстрирует возможность переноса визуального языка исходного датасета с помощью Stable Diffusion и LoRA. Нейросеть сохранила основные характеристики материала: чёрно-белую палитру, повторяющиеся ракурсы, узнаваемые силуэты людей, зернистость и принцип наложения текстур непосредственно на фотографию. Материалы в большинстве случаев остаются различимыми, благодаря чему изображения сохраняют связь с исходной эстетикой.
При генерации отдельные признаки датасета не просто копируются, а комбинируются в новых визуальных сочетаниях. Меняются плотность текстуры, распределение теней, характер поверхности и взаимодействие фигуры с фоном, тогда как композиция и общий стилистический строй остаются относительно устойчивыми.Вместе с тем воспроизведение стиля не гарантирует точности изображения. Размытые лица, избыточные тени и неестественные отражения обнаруживают ограничения модели в передаче анатомии, освещения и физических свойств материалов. В некоторых генерациях возникают смысловые несоответствия: визуально узнаваемые элементы соединяются без убедительной внутренней логики.
Эксперимент показывает принципиальное различие между воспроизведением формы и сохранением авторского высказывания. LoRA позволяет перенести узнаваемые признаки визуального языка, но не обеспечивает полного контроля над их взаимодействием. Итоговая серия соответствует первоначальной концепции, одновременно выявляя границу между стилистической точностью и смысловой целостностью изображения.
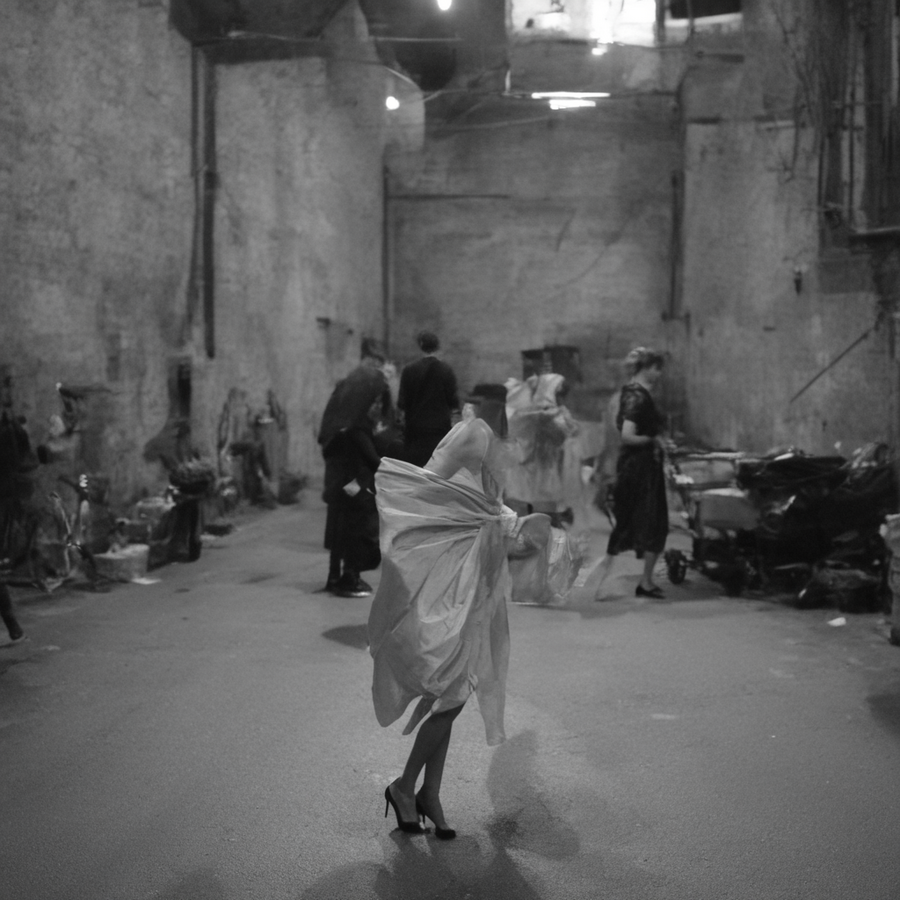
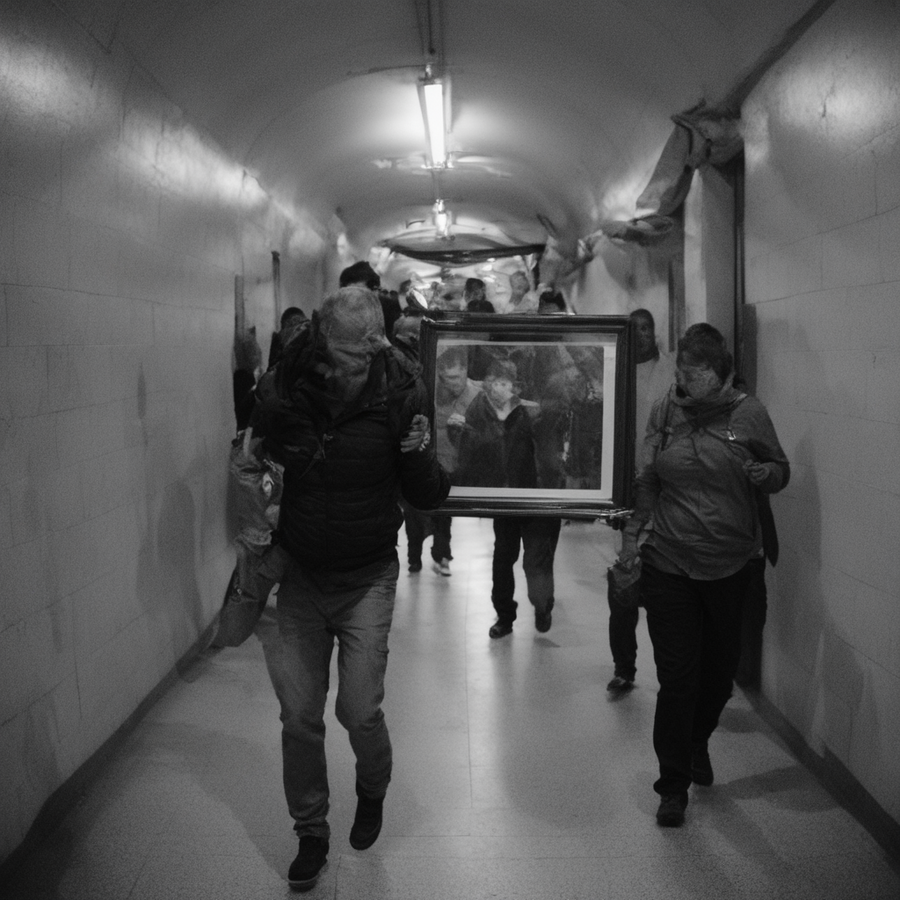
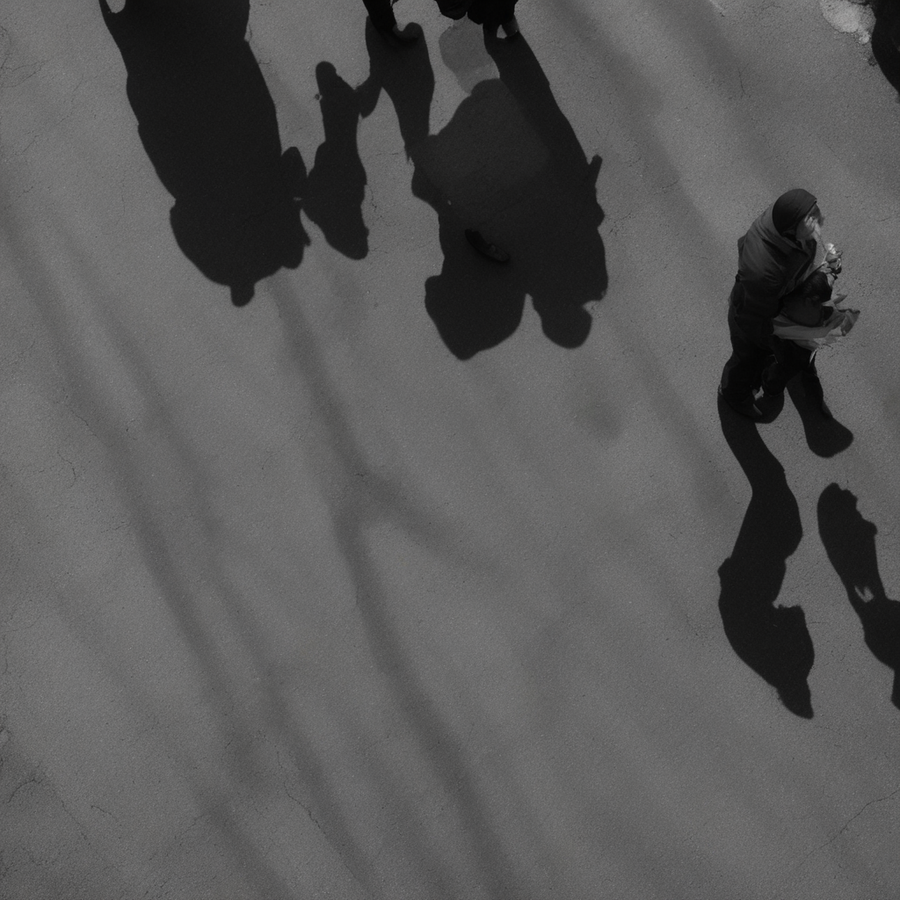
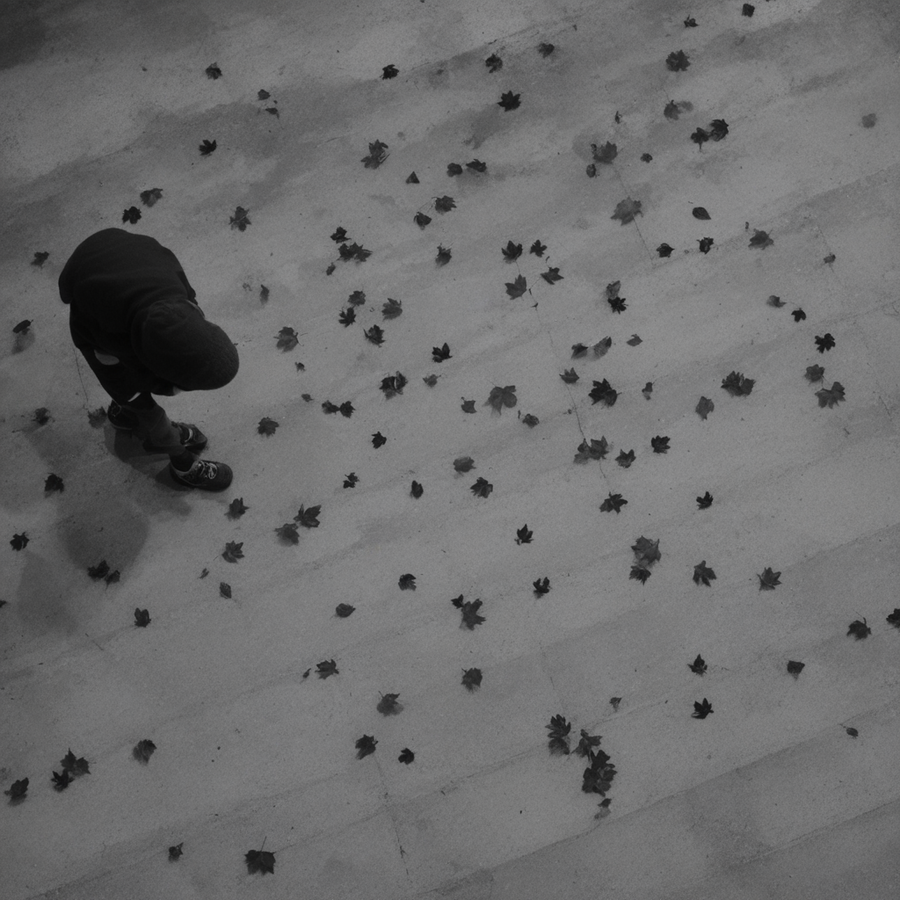
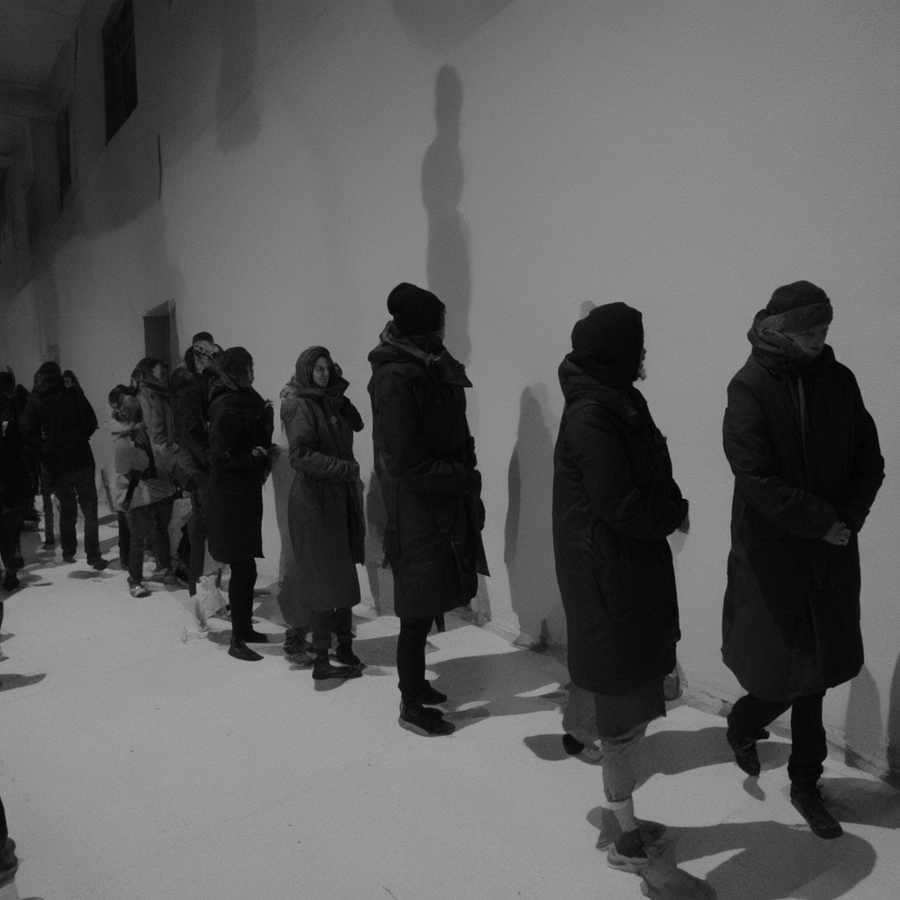
Неудачные генерации
Использование генеративного ИИ
В проекте использованы:
Stable Diffusion XL 1.0 + LoRA — генерация итоговой серии после дообучения;
BLIP — создание черновых текстовых описаний изображений для метаданных;
ChatGPT (OpenAI) — помощь в структуре проекта. Итоговые изображения создаются обученной SDXL + LoRA в Google Colab.
Для улучшения изображения никакие дополнительные сервисы не использовались.