Концепция
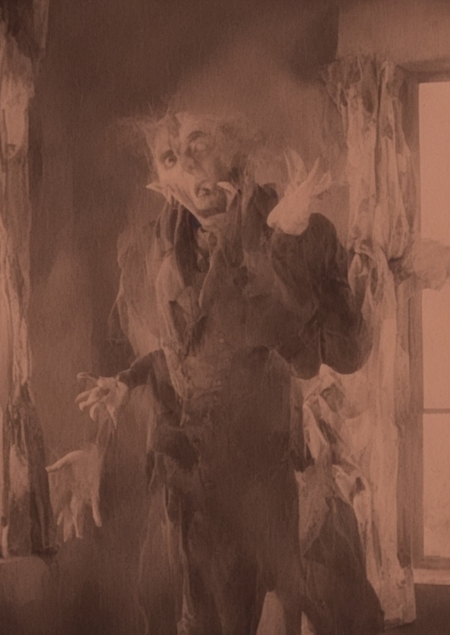
Хоррор как жанр проделал огромный путь за последние десятки лет. Это один из тех жанров, который постоянно развивается и меняет подходы, чтобы удивить зрителя и вызвать сильные эмоции. Однако иногда случается так, что вдохновение приходит из опыта прошлого.В последнее время немалую популярность приобрела эстетика аналогового хоррора, которая использует старые VHS-кассеты, аналоговое телевидение и радиоэфиры. В связи с этим у меня появился интерес: можно ли обучить генеративную модель под эстетику аналогового хоррора. В качестве основы был выбран фильм «Носферату, симфония ужаса» 1922 года, который заложил фундамент для всего жанра фильмов ужасов и визуального языка кинематографа.
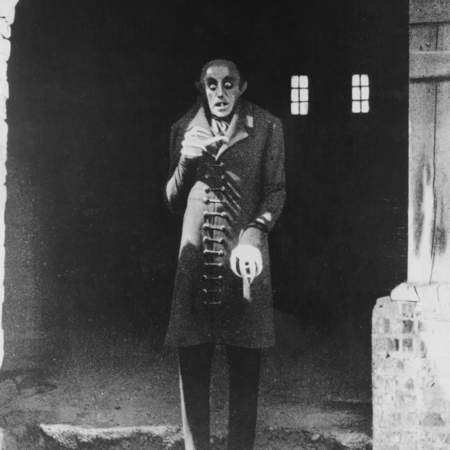
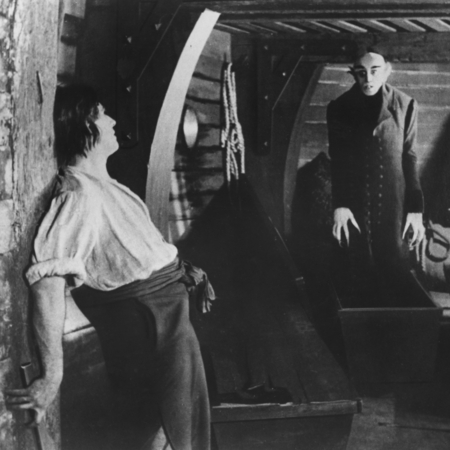
Примеры изображений, использованных для обучения генеративной модели
Таким образом, цель проекта — обучить генеративную модель Stable Diffusion XL воспроизводить визуальный стиль фильма «Носферату, симфония ужаса», создавая изображения в стиле аналогового хоррора.В рамках выполнения проекта было важно проверить может ли модель воспроизводить пугающие сцены, сохранять стилистику старой пленки и монохромную палитру.
Датасет
Для обучения модели был собран небольшой датасет из 60 изображений, которые были взяты как напрямую из фильма, так и из обновленной версии в более высоком качестве.
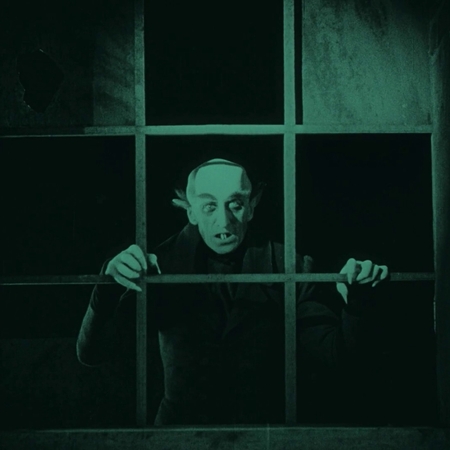
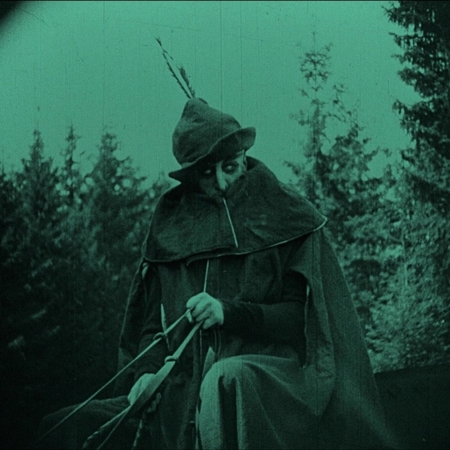
Примеры изображений, использованных для обучения генеративной модели
После сбора материала нужно было подготовить датасет: изображения были приведены к единому формату. Кадры фильма пришлось обрезать, кадрирование проводилось по персонажам в сцене. Все кадры фильма были приведены к квадратному формату 1:1 с разрешением 512 × 512 пикселей.При подборе кадров было важно обращать внимание на персонажей в кадре, чтобы их было не слишком много. Кроме того, хотелось передать стилистические особенности старого кино: монохромность, помехи в изображении и высокая контрастность.
Процесс обучения модели
Вся работа над проектом выполнялась в среде Google Colab с использованием GPU. В роли базовой модели выступила Stable Diffusion XL 1.0, дальнейшее обучение осуществлялось методом DreamBooth + LoRA. Ради экономии времени был выбран именно этот вариант, так как он не требует переобучения модели полностью, а позволяет адаптировать модель под какой-то визуальный стиль, что не требует большого датасета.
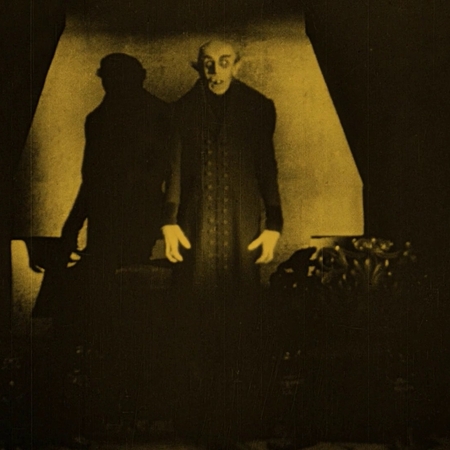
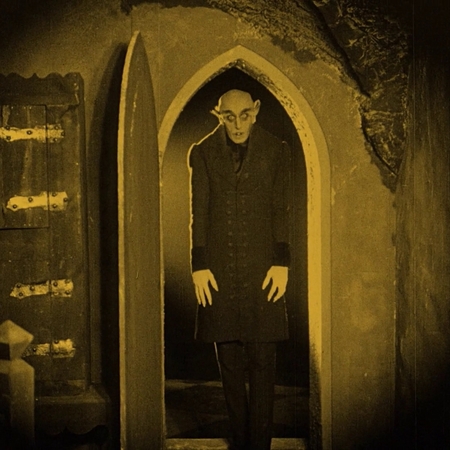
Примеры изображений, использованных для обучения генеративной модели
После подключения к среде и установки всего необходимого, пришло время для загрузки исходных изображений в среду Colab. После этого этим изображениям нужно было описание, которое легко можно было добавить при помощи модели BLIP.Вскоре датасету были заданы основные параметры для обучения. Это как путь к датасету, директория созранения результатов, так и текстовое описание стиля от модель BLIP и число шагов обучения. Основным токеном была обозначена фраза «horror photo in NOSFERATU style», этой фразой описывались все изображения, с дополнениями от модели BLIP.
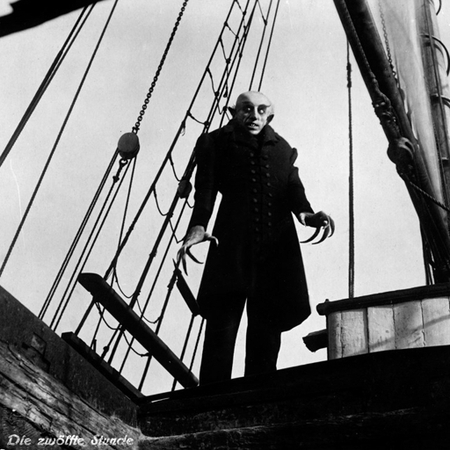
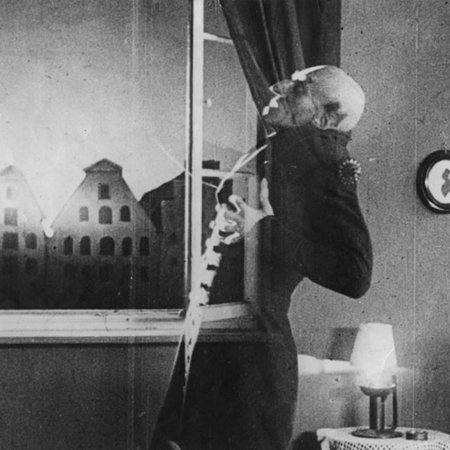
Примеры изображений, использованных для обучения генеративной модели
После подготовки датасета и обработки описаний можно было переходить к этапу обучения. Весь процесс осуществлялся на базе скрипта train_dreambooth_lora_sdxl.py. Обучение проходило в разрешении 512 пикселей, числом шагов в 1000 и чекпоинтом в 500.Как только обучение было завершено, можно было сохранить результат и перейти к генерации. Была загружена базовая модель Stable Diffusion XL, к которой были подключены полученные веса LoRA.Можно было приступать к генерации по текстовым промптам. Все описания затрагивали человека так или иначе, и включали в себя элемент ужаса.
Ссылка на блокнот: Открыть в Google Colab
Результирующие изображения
В результате генерации получились изображения в тематике аналогового хоррора. Модели удалось сохранить монохромность, текстуру старой записи и, в некоторых изображениях, похожесть персонажей.В нескольких изображениях получился эффект распадающейся реальности, неприятной сломанности тел и окружающих предметов. Смотреть на эти изображения неприятно, складывается чувство температурных сновидений, потери связи с реальностью.
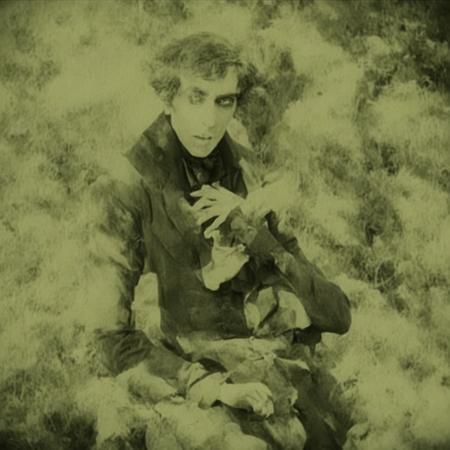
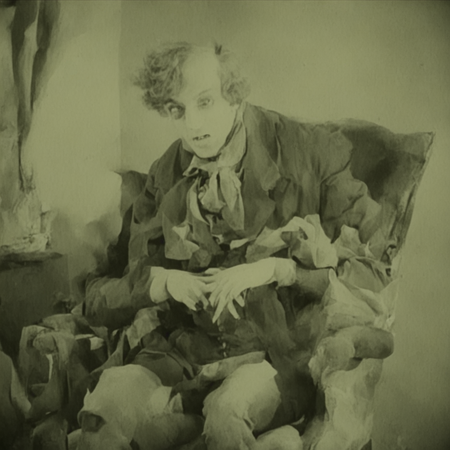
Результирующие изображения Промпты: Death of Artist, Madness
В случаях, когда в промпте описывалось действие или эмоции, генерация начинала искажаться, как будто сама модель не могла осознать сложный концепт. Изображение плывет и разваливается, что правда похоже на состояние безумия, в котором человек утрачивает способность здраво воспринимать реальность.Если же вписывать простые описания, без эмоций и движения, то изображение генерируется в более очевидной форме. Что вызывает еще меньше интереса, даже неприятное чувство от сломанного изображения сглаживается и становится не настолько заметным.
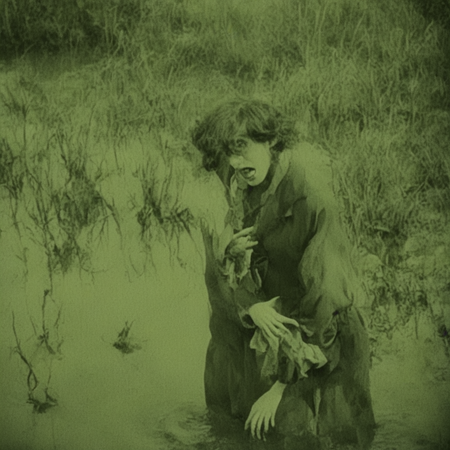
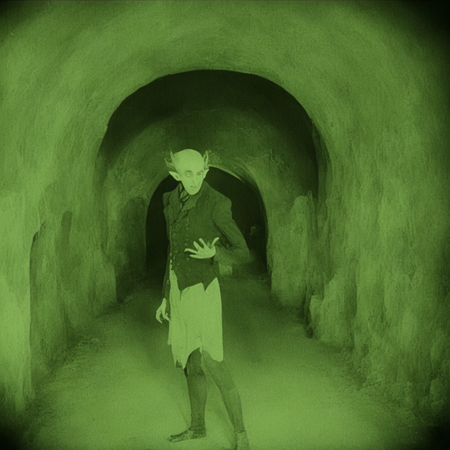
Результирующие изображения Промпты: Crying woman standing in the water, a man standing in a tunnel with a green light
Хоть изображения и похожи на стилистику аналогового хоррора, им не удается вызвать никаких эмоций. Хоррор, как жанр опирающийся в первую очередь на сильные эмоции, становится беззубым в попытке рассчитать его математически.Изображениям не удается никак удивить, в них нет истории как в «проклятых» изображениях в стилистике аналогового хоррора, эмоций в них также нет. Даже при повторении оболочки, генерации не удалось скопировать наполнение.
Результирующие изображения Промпт: Shadow Man
Можно сделать несколько выводов из данного эксперимента.Во-первых у модели действительно получилось ухватить стилистические особенности изображений: они сохраняют монохромность, текстуру шума, в некотором роде даже персонажей.Во-вторых это визуальное подражание не имеет под собой ничего, что трогало бы человеческое воображение. Изображения проваливаются не только в попытке вызвать испуг, но и любые другие эмоции. Они пустые. В них нет истории, нет понимания, что именно может напугать зрителя.Таким образом можно сказать, что подобное подражание не особо эффективно в хорроре, так как у модели нет понимания о человеческих эмоциях, а контроль над процессом настолько мал, что человеческий вклад в эти генерации равен нулю.
Результирующие изображения Промпт: a man standing on top of a hill
Результирующие изображения Промпт: a man standing in front of a door
Описание применения генеративных моделей
- Для генерации изображений использовалась генеративная модель Stable Diffusion XL 1.0
(https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0).
Выступала в качестве базовой модели, на основе которой происходило дообучение.2. В дообучении использовался метод DreamBooth + LoRA
(https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0).
Для дообучения на малом количестве изображений использовался DreamBooth, для сохранения результата использовалась LoRA, которая позволяет сохранить результат обучения без необходимости дублировать всю базовую модель.