РУБРИКАТОР
- Вводная часть
- Обработка данных
- Стилизация графиков
- Графики
- Описание применения генеративной модели
- Ссылки
- Источники информации
ВВОДНАЯ ЧАСТЬ
Для работы я выбрала датасет Coffee Taste Test из открытых данных сайта Kaggle.
Я выбрала этот датасет, потому что очень люблю кофе и обязательно выпиваю как минимум одну чашку каждый день. Мне стало интересно проанализировать какие-нибудь данные, связанные с кофе.
В своей работе я использовала четыре вида графиков: круговая диаграмма, столбчатая диаграмма, горизонтальная столбчатая диаграмма и коробочная диаграмма. Я подумала, что эти четыре больше всего подходят для стилизации под кофейную тему, поскольку круговая напоминает вид сверху на чашку, столбчатая — вид сбоку, горизонтальная — стол, а коробочная навивает мысли о коробках для кофе.
ОБРАБОТКА ДАННЫХ
Процесс обработки данных начался с подключения необходимых библиотек: pandas, matplotlib.pyplot, seaborn, numpy. Затем, я добавила датасет и вырезала из него только те колонки, которые буду анализировать.
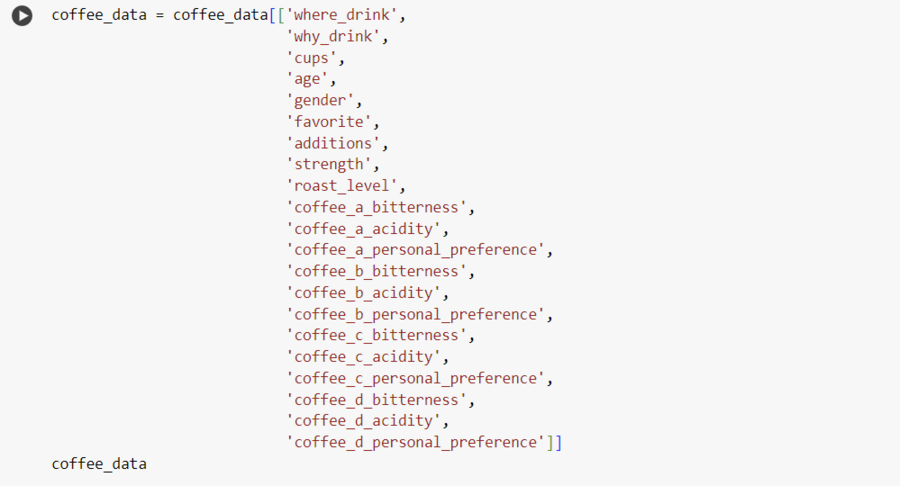
Список колонок из таблицы, которые понадобятся
Дальше я прошлась по всем выбранным колонкам и посчитала сколько пропусков в каждой колонке.
Выявление пустых ячеек
Получив результат подсчета, я сформировала гипотезу: в данных есть люди, про которых мало что известно, и большинство пропусков относятся к ним. Чтобы ее проверить я посчитала количество людей с пропусками.
Количество людей с пропусками в данных
Оказалось, что строк с пропусками примерно 13% от общего числа. Я решила убрать проблемные строчки, поскольку еще останется 87% данных, по которым будет удобнее строить графики.
Убираем пустые строки
Далее я убрала лишние данные в строке «Пол», оставив только «Male» и «Female», а остальные объединила под названием «Other».
Обработка данных колонки «Пол»
После этого я приступила к построению графиков по данным. Сначала я анализировала где и по какой причине люди пьют кофе. Результат представлялся в виде круговых диаграмм.
Выявление места и причины для питья кофе
Следующий график отражает любимые напитки и топпинги. Результат представлялся в виде столбчатых диаграмм.
Любимые напитки и топпинги
Следующая диаграмма отражает сколько чашек кофе пьют люди разных возрастов. Ширина полосы показывает процент людей по количеству чашек из 100%. Результат представлялся в виде горизонтальных диаграмм.
Чашки кофе на возраст
После нее созданы подобные диаграммы с анализом предпочтений по крепости и прожарке среди людей разных возрастов.
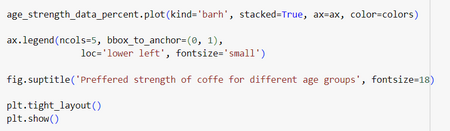
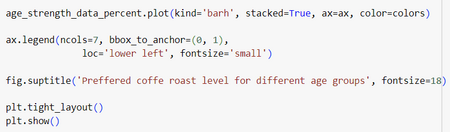
Крепкость / Прожарка
Последние четыре диаграммы посвящены оценке четырех кофейных напитков у групп разных возрастов и с показателями по полу. Результат представлялся в виде коробочных диаграмм.
Оценка напитков 1
Оценка напитков 2
Оценка напитков 3
Оценка напитков 4
СТИЛИЗАЦИЯ ГРАФИКОВ
У меня не было конкретного референса для стилизации, я хотела придумать ее сама. Поэтому нашла только названия цвето, создала график-палитру с оттенками кофейных напитков и использовала эти цвета для окрашивания диаграмм. Также я прочитала, что можно создать паттерны из знаков ’’-’’, ’’/’’, ’’.’’, ’’*’’ и ’’||’’, поэтому некоторые графики дополнила паттернами.